本人常用Mi5s,伴随着MIUI9(7.0)内测,实在等不急官网放MIUI的包(其实是不想使用MIUI,设计风格跟原生差异太大)。

这几天就靠着以前的所积累的刷机经验,并且刷上刚适配的lineage os (CM14.1),以此为基础,替换AOSP(Android Open-Source Project)编码的应用。

再加 上pixel launcher 谷歌“亲儿子”的美化和Nougat的优化,对原生的安卓顿生好感。

当然,刷机过程也是比较曲折的,但总算没有白费精力,为了以后类似操作便捷,特地记录一下。

Step1: 小米官网解锁fastboot

​ 小米自从mi4后,为了增强安全性(防止大家乱刷机),至底层加入bl锁,导致刷入第一步需解锁,但刷机有风险,一旦解锁,就失去保修机会,且修改不可逆,小米会将设备解锁信息在服务器上保存,谨慎操作!

Step2: adb刷入第三方recovery(TWRP)

  1. 去https://twrp.me/下载最新的TWRP(我当时最新版本3.1.1.0),为之后刷第三方系统做准备,并用adb(Android Debug Bridge)工具包刷入TWRP

ADB下载地址:http://adbshell.com/downloads 选择ADB Kits

  1. 手机关机进入fastboot模式(音量键下+电源键),USB连接电脑,装上驱动(用官方驱动或者第三方驱动安装软件)

powershell 刷入命令

1
.\fastboot flash recovery XXX.img
  • XXX.img代表TWRP所下载的文件名
  1. 最后输入命令重启,再关机,按住 音量键上+电源键 进入recovery模式
1
.\fastboot reboot

Setp3: 刷入lineage os(with root)

去lineage os官网下载rom包和root包,在recovery模式下,用TWRP依次刷入两个包

网址:https://download.lineageos.org/

注意:根据设备cpu类型选择root包(我的是arm64,安卓7.1)

Step4: 刷入openGapps(aroma)

网址:http://opengapps.org/

根据设备类型选择包

  • aroma : 图形化安装版本,可以自定义所需刷入的应用。(但有些机型会由于recovery的原因无法使用)。

  • **super :**最为完备的版本,该有的和不该有的都有了(比如日语输入法、注音输入法、等大陆用户基本上不会需要的应用)

  • stock :包括 nexus 出厂所具备的所有应用,在安装好 CM 、魔趣等系统后,刷入该包会自动替换掉 Aosp 的应用 ,比如 Google 相机、Gmail、Google Now 桌面、Google 相册分别替换掉 Aosp所带的 相机、 邮件、桌面、相册等,当然 Google全家桶的其他软件如 Gooele Play、Youtube、地图、Gooele keep等也会随之刷入你手机。

  • **full :**与 stock 唯一区别就在于不会替换掉 Aosp 应用。

  • mini、micro、nano、pico **:**依次减少应用,但都具备 Google service 和 Play

推荐nano包,但下载时需要一个稳定的梯子,建议用chrome直接下载,最后用TWRP刷入既可。

Step5: 精简部分不需要系统应用+修改hosts

该布操作最简单,但比较繁琐,用root删除掉内置的一些不需要使用的google应用,比如其他语言输入法,删除完后重启手机一次。

用go hosts APP替换掉原始hosts,使设备能直接访问谷歌(该操作并不完美,但可以用做备用)

Step6: 刷入Magisk框架并接入viperfx音效

因为手机并不自带音效改善软件,且不带HIFI模块的手机插手机的音效很差,所以这里刷入现在口碑最好的viperfx音效,但直接刷入时会存在I/O报错,root报错等原因,所以这里借助Magisk框架修改系统API接口实现同等功能

Magisk 下载网址:https://forum.xda-developers.com/apps/magisk/official-magisk-v7-universal-systemless-t3473445

  1. 先TWRP刷入Magisk ;
  2. 再开机安装Magisk Manager apk;
  3. 最后在magisk中安装viperfx即可。

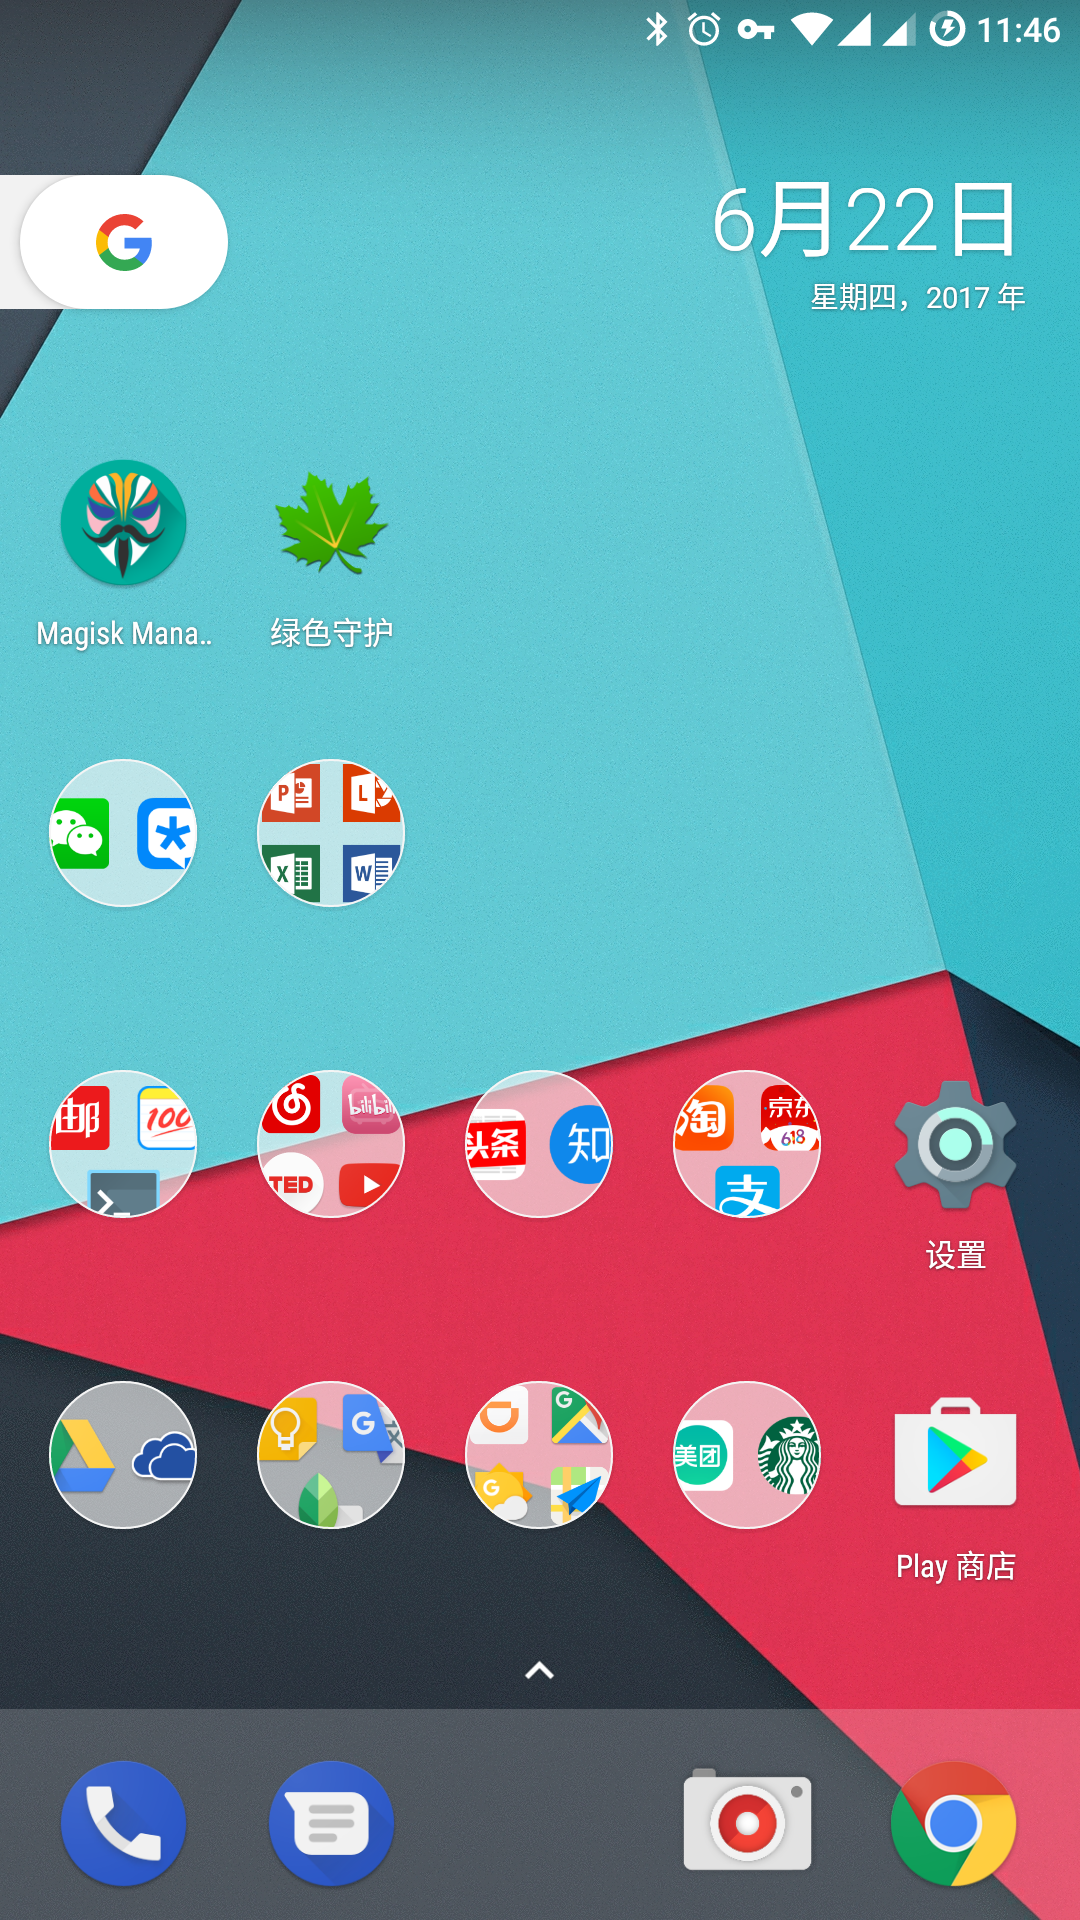
最终效果图

题目描述:

小明喜欢在一个围棋网站上找别人在线对弈。这个网站上所有注册用户都有一个积分,代表他的围棋水平。

小明发现网站的自动对局系统在匹配对手时,只会将积分差恰好是K的两名用户匹配在一起。如果两人分差小于或大于K,系统都不会将他们匹配。

现在小明知道这个网站总共有N名用户,以及他们的积分分别是A1, A2, … AN。

小明想了解最多可能有多少名用户同时在线寻找对手,但是系统却一场对局都匹配不起来(任意两名用户积分差不等于K)?

输入:

第一行包含两个个整数N和K。

第二行包含N个整数A1, A2, … AN。

对于30%的数据,$1 \le N \le 10​$

对于100%的数据,$1 \le N \le 100000, 0 \le Ai \le 100000, 0 \le K \le 100000$

输出:

一个整数,代表答案。

样例输入:
5
1 2
3 1
2 4
2 5
5 3

样例输出:
6

再比如,

样例输入:

10 1

2 1 1 1 1 4 4 3 4 4

样例输出:
8

资源约定:

峰值内存消耗 < 256M

CPU消耗 < 1000ms

请严格按要求输出,不要画蛇添足地打印类似:“请您输入…” 的多余内容。

所有代码放在同一个源文件中,调试通过后,拷贝提交该源码。

注意: main函数需要返回0

注意: 只使用ANSI C/ANSI C++ 标准,不要调用依赖于编译环境或操作系统的特殊函数。

注意: 所有依赖的函数必须明确地在源文件中 #include , 不能通过工程设置而省略常用头文件。提交时,注意选择所期望的编译器类型。

问题分析:

​这题就相较于前几题就有难度提升,不在依靠于单一基础算法就能较好的解决问题。

​比赛时,我一开始就认为搜索能解决问题,纸上推演的半个小时才发现有问题,始终是一个NP问题。后来经过分析:这样的策略可能达到解决问题的目的:

  1. 因为当K>0时,若选值为m的点,则应该选上值为m的所有点,依照桶排序的思想,进行优化

  2. 当K=0时,最大选择数=不同值的点的类别数

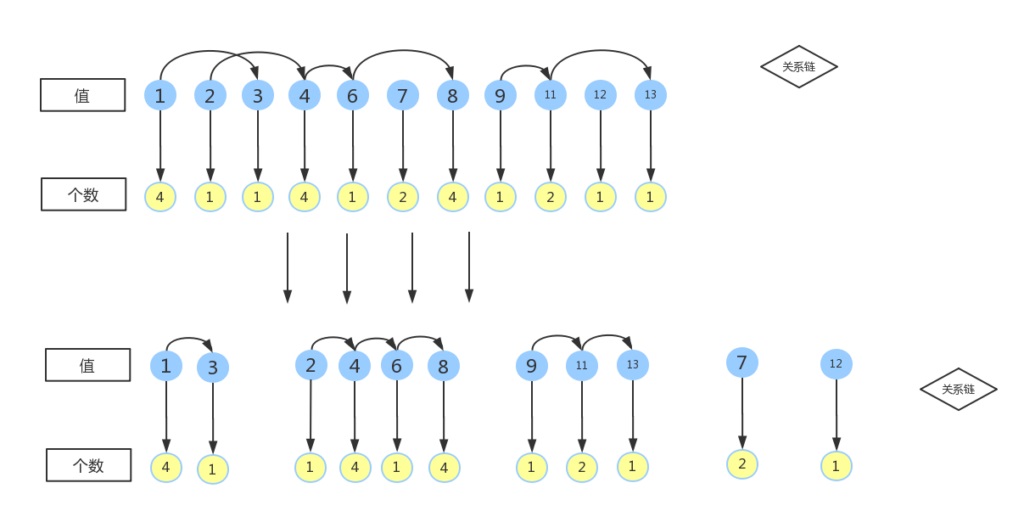
  3. 依照K值,形成关系链(可以为多条关系链)

  4. 单一关系链中,选择类数和并且不关联的最大一个或几个点,该算法应为动态规划

如图所示:

输入:

1
2
22 2  
2 1 1 1 1 4 4 3 4 4 6 7 7 8 8 8 8 9 11 11 12 13

  • 第一条链最大个数和:4
  • 第二条链最大个数和:8
  • 第三条链最大个数和:2
  • 第四条链最大个数和:2
  • 第五条链最大个数和:1

最大个数和:$4 + 8 + 2 + 2 + 1 = 17$

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
#include <iostream>
#include <vector>
#include <algorithm>
#include <array>

const int N = 100000;
int n, k;
std::array<int, N> num{0};
std::vector<int> link[N];
int node[N];
int num_node = 0;
int num_link = 0; // 关系链数
std::array<short, N> vis{0}; // 1代表已访问,0代表未访问,-1代表点不存在
std::array<int, N> F{0}; // dp F[i]=max(F[i-1],F[F-2]+num[i])
long long tot = 0;

void init() {
std::cin >> n >> k;
for (int i = 1; i <= n; i++) {
int t;
std::cin >> t;
num[t]++;
vis[i] = -1;
}

}

void work() {
for (int i = 0; i <= N; i++)
if (num[i] != 0) {
node[num_node++] = i;
vis[i] = 0;
}
for (int i = 0; i < num_node; i++) {
if (vis[node[i]] == 0) {
vis[node[i]] = 1;
link[num_link].push_back(node[i]);
int next = node[i] + k;
while (vis[next] == 0) {
link[num_link].push_back(next);
vis[next] = 1;
next = next + k;
}
num_link++;
}
}
}

void dp() {
for (int i = 0; i < num_link; i++) {
F.fill(0);
for (int j = 0; j < link[i].size(); j++) {
if (j >= 2)
F[j] = std::max(F[j - 1], F[j - 2] + num[link[i][j]]);
else if (j == 0)
F[j] = num[link[i][j]];
else if (j == 1)
F[j] = std::max(F[j - 1], num[link[i][j]]);
}
// std::cout << F[link[i].size() - 1] << std::endl;
tot += F[link[i].size() - 1];
}
}

int main() {
init();
work();
dp();
std::cout << tot;
/*
for (int i = 0; i < num_node; i++)
std::cout << node[i] << "->" << num[node[i]] << " ";
std::cout << std::endl;

for (int i = 0; i < num_link; i++) {
for (int j : link[i]) {
std::cout << j << " ";
}
std::cout << std::endl;
}
*/
return 0;
}

题目描述:

跳蚤国正在大力发展旅游业,每个城市都被打造成了旅游景点。

许多跳蚤想去其他城市旅游,但是由于跳得比较慢,它们的愿望难以实现。这时,小C听说有一种叫做火车的交通工具,在铁路上跑得很快,便抓住了商机,创立了一家铁路公司,向跳蚤国王请示在每两个城市之间都修建铁路。

然而,由于小C不会扳道岔,火车到一个城市以后只能保证不原路返回,而会随机等概率地驶向与这个城市有铁路连接的另外一个城市。跳蚤国王向广大居民征求意见,结果跳蚤们不太满意,因为这样修建铁路以后有可能只游览了3个城市(含出发的城市)以后就回来了,它们希望能多游览几个城市。于是跳蚤国王要求小C提供一个方案,使得每只跳蚤坐上火车后能多游览几个城市才回来。
小C提供了一种方案给跳蚤国王。跳蚤国王想知道这个方案中每个城市的居民旅游的期望时间(设火车经过每段铁路的时间都为1),请你来帮跳蚤国王。

【输入格式】

输入的第一行包含两个正整数n、m,其中n表示城市的数量,m表示方案中的铁路条数。
接下来m行,每行包含两个正整数u、v,表示方案中城市u和城市v之间有一条铁路。
保证方案中无重边无自环,每两个城市之间都能经过铁路直接或间接到达,且火车由任意一条铁路到任意一个城市以后一定有路可走。

【输出格式】

输出$n$行,第$i$行包含一个实数$t_i$,表示方案中城市$i$的居民旅游的期望时间。你应当输出足够多的小数位数,以保证输出的值和真实值之间的绝对或相对误差不超过$e^{-9}$。

【样例输入】
4 5
1 2
2 3
3 4
4 1
1 3

【样例输出】
3.333333333333
5.000000000000
3.333333333333
5.000000000000

【样例输入】

10 15
1 2
1 9
1 5
2 3
2 7
3 4
3 10
4 5
4 8
5 6
6 7
6 10
7 8
8 9
9 10

【样例输出】
10.000000000000
10.000000000000
10.000000000000
10.000000000000
10.000000000000
10.000000000000
10.000000000000
10.000000000000
10.000000000000
10.000000000000

【数据规模与约定】
对于10%的测试点,$n \le 10$;
对于20%的测试点,$n \le 12$;
对于50%的测试点,$n \le 16$;
对于70%的测试点,$n \le 19$;
对于100%的测试点,$4 \le k \le n \le 21,1 \le u, v \le n$。数据有梯度。

资源约定:

峰值内存消耗 < 256M

CPU消耗 < 1000ms

请严格按要求输出,不要画蛇添足地打印类似:“请您输入…” 的多余内容。

所有代码放在同一个源文件中,调试通过后,拷贝提交该源码。

注意: main函数需要返回0

注意: 只使用ANSI C/ANSI C++ 标准,不要调用依赖于编译环境或操作系统的特殊函数。

注意: 所有依赖的函数必须明确地在源文件中 #include , 不能通过工程设置而省略常用头文件。提交时,注意选择所期望的编译器类型。

问题分析:

​这道问题真的很难,当时间也很紧,就剩余20分钟左右,考试直接放弃了。现在并没有明确思路,待网上有题解后,有机会再补充。

0%