某些题目,由于要计算的答案非常大(超出64位整数的范围),会要求把答案对 $10^9 + 7$取模。如果在计算中途没有处理得当的话,会出现WA(错误)或则TLE(超时)。

例如计算多项乘积时,如果没有中途及时取模,乘法结果会溢出(例如C/C++),从而得到非预期的答案
。对于 Python 来说,虽然没有溢出,但是大整数(big integer)之间的运算不是 $O(1)$,可能会导致LTE。

加法和乘法的取模

一般涉及到取模($\bmod$)的题目,会用到如下两个恒等式
$$ \begin{align} (a+b) \bmod m &= ((a \bmod m) + (b \bmod m)) \bmod m \\ (a \cdot b) \bmod m &= ((a \bmod m) \cdot (b \bmod m)) \bmod m \\ \end{align} $$

证明:根据带余除法,${\forall} a \in \mathbb{z}$,都可以表示为$a = qm + r\ (m \neq 0)$,其中整数$q$为$a$除以$m$的商(quotient),整数$r$为$a$除以$m$的余数(remainder),即$r = a \bmod m$。

设$a = q_1 m + r_1$,$b = q_2 m + r_2$。
第一个恒等式:
$$ \begin{align} (a+b) \bmod m &= (q_1 m + r_1 +q_2 m + r_2) \bmod m \\ &=((q_1 + q_2)m + r_1 + r_2) \bmod m \\ &=(r_1 + r_2) \bmod m \end{align} $$
又因为$r_1 = a \bmod m$,$r_2 = b \bmod m$有:
$$ (a+b) \bmod m = ((a \bmod m) + (b \bmod m)) \bmod m $$

第二个恒等式:
$$ \begin{align} (a\cdot b) \bmod m &= ((q_1 m + r_1)(q_2 m + r_2)) \bmod m \\ &= (q_1 q_2 m^2 + (q_1 r_2 + q_2 r_1)m + r_1 r_2) \bmod m \\ &=(r_1 r_2) \bmod m \end{align} $$

同样有:
$$ (a\cdot b) \bmod m =((a \bmod m)\cdot (a \bmod m)) \bmod m $$

根据这两个恒等式,我们可以在计算过程中(例如循环中),对加法和乘法的结果取模,而不是在计算最终结果后再取模。

注意:如果涉及到幂运算,不能随意取模。如果指数为整数,可以用快速幂。

如果计算过程中有减法,可能会产生负数,处理不当也会导致 WA。如何正确处理这种情况呢?

同余

首先引入同余(congruence modulo) 的概念。
两个整数$a$,$b$,若它们除以正整数$m$所得的余数相等,则称$a$,$b$对于模$m$同余,记作:
$$ a \equiv b \pmod m $$

例如$42 \equiv 12 \pmod {10}$,因为$42$和$12$都可以被$10$整除,余数都是$2$。

负数的取模

对于负数,我们可以将其转化为对应的非负数再取模。例如,$-17 \bmod 10$可以转化为$((-17 \bmod 10) +10) \bmod 10 = (-7 +10) \bmod 10$,结果是$3$。
也就是说,如果我们发现 $(x \bmod m) < 0$,可以加上一个$m$,得到非负数。

为避免判断$x\bmod m < 0$,可以写成
$$ (x \bmod m + m) \bmod m $$

这样无论$x$是否为负数,运算结果都会落在区间$[0,m−1]$中。

除法的取模

如果要计算$\frac{24}{8} \bmod 5$,如果像加法或乘法处理,写成$\frac{24 \bmod 5}{8 \bmod 5} \bmod 5 = \frac{4}{3}$,明显不是正确答案$3$。先有结论:

如果$p$是一个质数,$a$是$b$的倍数且$b$和$p$互质,那么有
$$ \frac{a}{b} \bmod p = (a \cdot b^{p-2}) \bmod p $$

如果实际题目中推导出了包含除法的求余式,可以用上式转换成乘法,并用快速幂计算$b^{p-2} \bmod p$。

证明:

  • 引理1: 当$p$是质数且$1 \leq i \leq p-1$时,有
    $$ \mathrm{C}_p^i \equiv 0 \pmod p $$

其中
$$ \mathrm{C}_p^i = \frac{p!}{i!(p-i)!} $$
证明:当$p$是质数且$1 \leq i \leq p-1$时,$\frac{p!}{i!(p-i)!}$分母一定不含$p$,由于分子中包含$p$且$\mathrm{C}_p^i$为整数,所以$\mathrm{C}_p^i$一定能被$p$整除,即$\mathrm{C}_p^i \equiv 0 \pmod p$。

  • 引理2: 根据二项式定理,有
    $$ (x+y)^p = \sum_{k=0}^{p}{\mathrm{C}_p^k x^{p-k} y^k} = \sum_{k=0}^{p}{\mathrm{C}_p^k x^k y^{p-k}} $$

当$p$为质数,且$x, y \in \mathbb{z}$时,除去$k=0$和$k=p$两项,根据引理1,其余项与$0$关于$p$同余。即
$$ \sum_{k=1}^{p-1}{\mathrm{C}_p^k x^{p-k} y^k} \equiv 0 \pmod p $$
拆分
$$ \begin{align} (x+y)^p &= \mathrm{C}_p^0 x^p y^0 + \sum_{k=1}^{p-1}{\mathrm{C}_p^k x^{n-k} y^k} + \mathrm{C}_p^p x^0 y^p \\ &=x^p + y^p + \sum_{k=1}^{p-1}{\mathrm{C}_p^k x^{n-k} y^k} \end{align} $$

于是当$p$为质数,且$x, y \in \mathbb{z}$时,有:
$$ (x+y)^p \equiv x^p + y^p \pmod p $$

根据费马小定律,对任意整数$a$和任意质数$p$,有:
$$ a^p \equiv a \pmod p $$
证明:当$a = 0$时,$0^p \equiv 0 \pmod p$成立;
已知引理2,通过归纳法,我们可以得到:
$$ (x_1+ … +x_n)^p \equiv x_1^p + … + x_n^p \pmod p $$

如果将$a$展开为$a$个$1$相加,$a=1+…+1$,代入上式有:
$$ a^p \equiv (1+ … +1)^p \equiv 1^p + … + 1^p \equiv a \pmod p $$

根据数学归纳法,原命题对于 $a\ge 0$ 成立。对于$a < 0$的情况同理,证明完毕。

如果$a$不是$p$的倍数,费马小定理也可以写成更加常用的一种形式:
$$ a^{p-1} \equiv 1 \pmod p $$
如果$a$是$p$的倍数,显然有:$a^{p-1} \equiv 0 \pmod p$。

在$a$不是$p$的倍数的前提下,两边同时乘以$\frac{b}{a}$,有
$$ b \cdot a^{p-2} \equiv \frac{b}{a} \pmod p $$

即
$$ \frac{b}{a} \bmod p = (b \cdot a^{p-2}) \bmod p $$

总结

1
2
3
4
5
6
7
8
9
// 如果取模到 [0, MOD-1] 中,无论正负
(a % MOD + MOD) % MOD

// 多个数相乘,要步步取模,防止溢出
(a * b * c) % MOD = a * b % MOD * c % MOD

// 除(MOD 是质数且 b 不是 MOD 的倍数)
(a / b) % MOD = a * qpow(b, MOD-2, MOD) % MOD // qpow 是快速幂

RTL8367S自制网管交换机

RTL8367S 芯片官网介绍

RTL8367S-CG

二层管理 5+2 端口 10/100/1000M 交换机控制器

概述

RTL8367S-CG 是一款 LQFP-128 封装的高性能 5+2 端口 10/100/1000M 以太网交换机,具有低功耗集成 5 端口 Giga-PHY,支持 1000Base-T、100Base-TX 和 10Base-T传输标准。

对于特定应用,RTL8367S 支持一个额外的接口,可配置为 RGMII/MII 接口。 RTL8367S 还支持一个可配置为 SGMII/HSGMII 接口的 Ser-Des 接口。 RTL8367S集成了高速交换机系统的所有功能;包括用于数据包缓冲的 SRAM、无阻塞交换结构以及单个 CMOS 器件中的内部寄存器管理。

特点

单芯片 5+2 端口 10/100/1000M 无阻塞交换架构

嵌入式 5 端口 10/100/1000Base-T PHY

每个端口支持全双工 10/100/1000M 连接(半双工仅在 10/100M 模式下支持)

额外接口(扩展 GMAC1)支持

SGMII (1.25GHz) 接口

HSGMII (3.125GHz) 接口

额外接口(扩展GMAC2)支持

媒体独立接口 (MII)

简化的 10/100/1000M 媒体独立接口 (RGMII)

通过 IEEE 802.3x 流量控制和背压进行全双工和半双工操作

应用

5 端口 1000Base-T 路由器,带 SGMII/HSGMII 和/或 MII/RGMII

芯片官网介绍:https://www.realtek.com/Product/Index?id=3699

RTL8367S-CG_Datasheet.pdf[1]

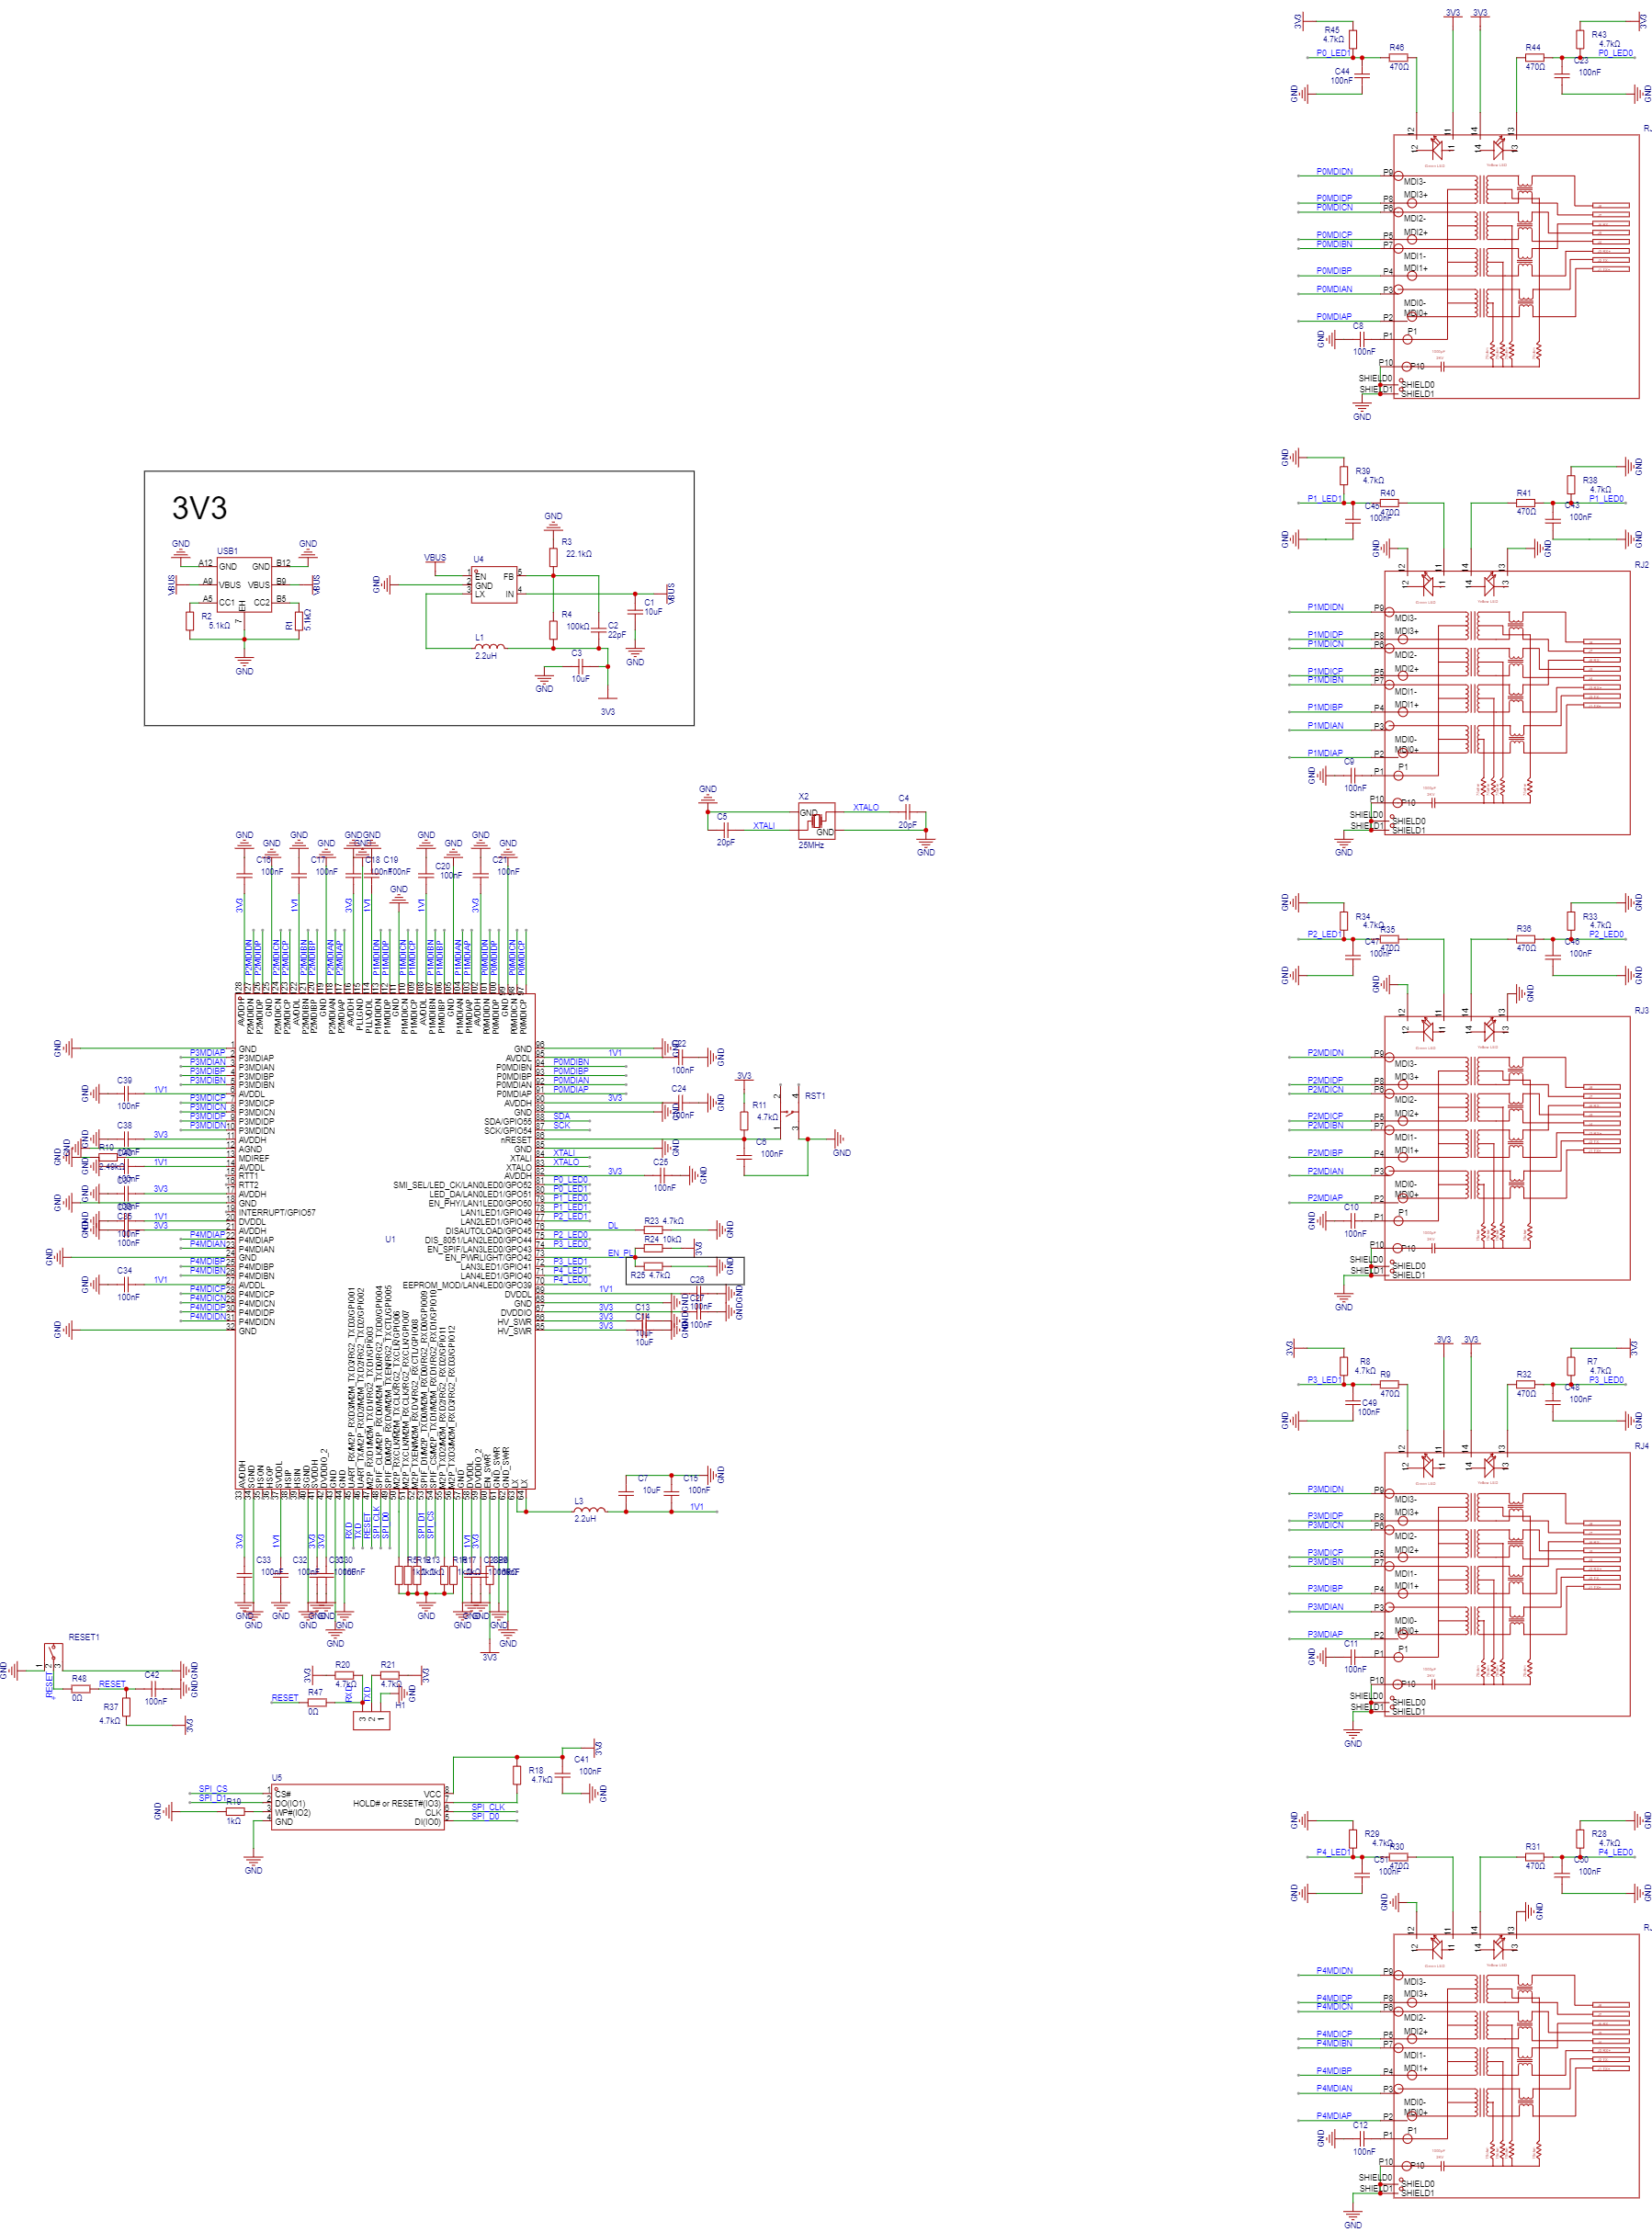
原理图

外围电路

  1. 使用 USB-C 输出5V电源
  2. 使用 SY8088IAAC 实现 5V 降压 3.3V,使用RTL8367S自带电压转换输出1.1V
  3. 使用 W25Q32JVSSIQ 4MB spi norflash 存储固件
  4. 使用 5个 HR911130A 自带变压器和 LED 的单端口RJ45连接器
  5. 转出 TX/RX 串口
  6. 带 3.3V 供电拉低按钮 + 芯片重置按钮
  7. 25M 晶振时钟

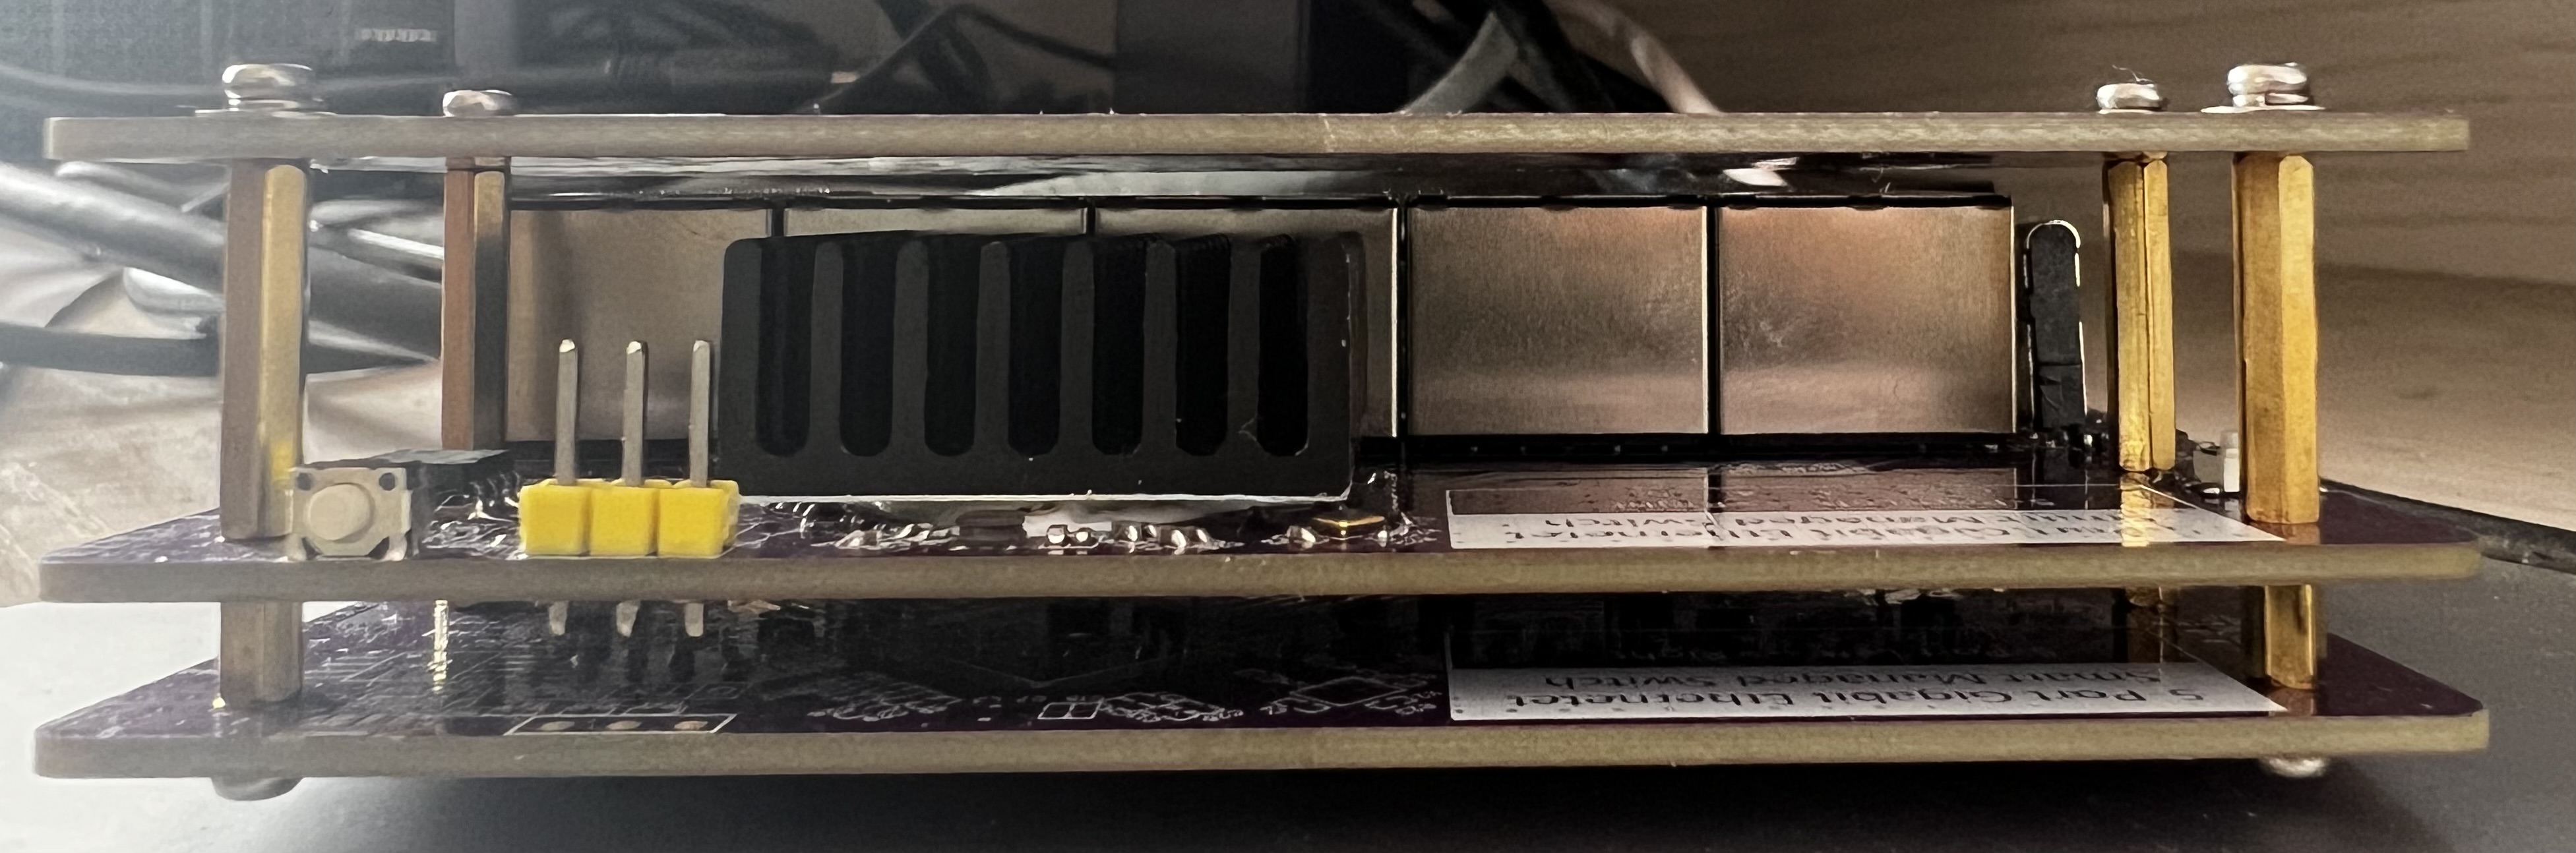
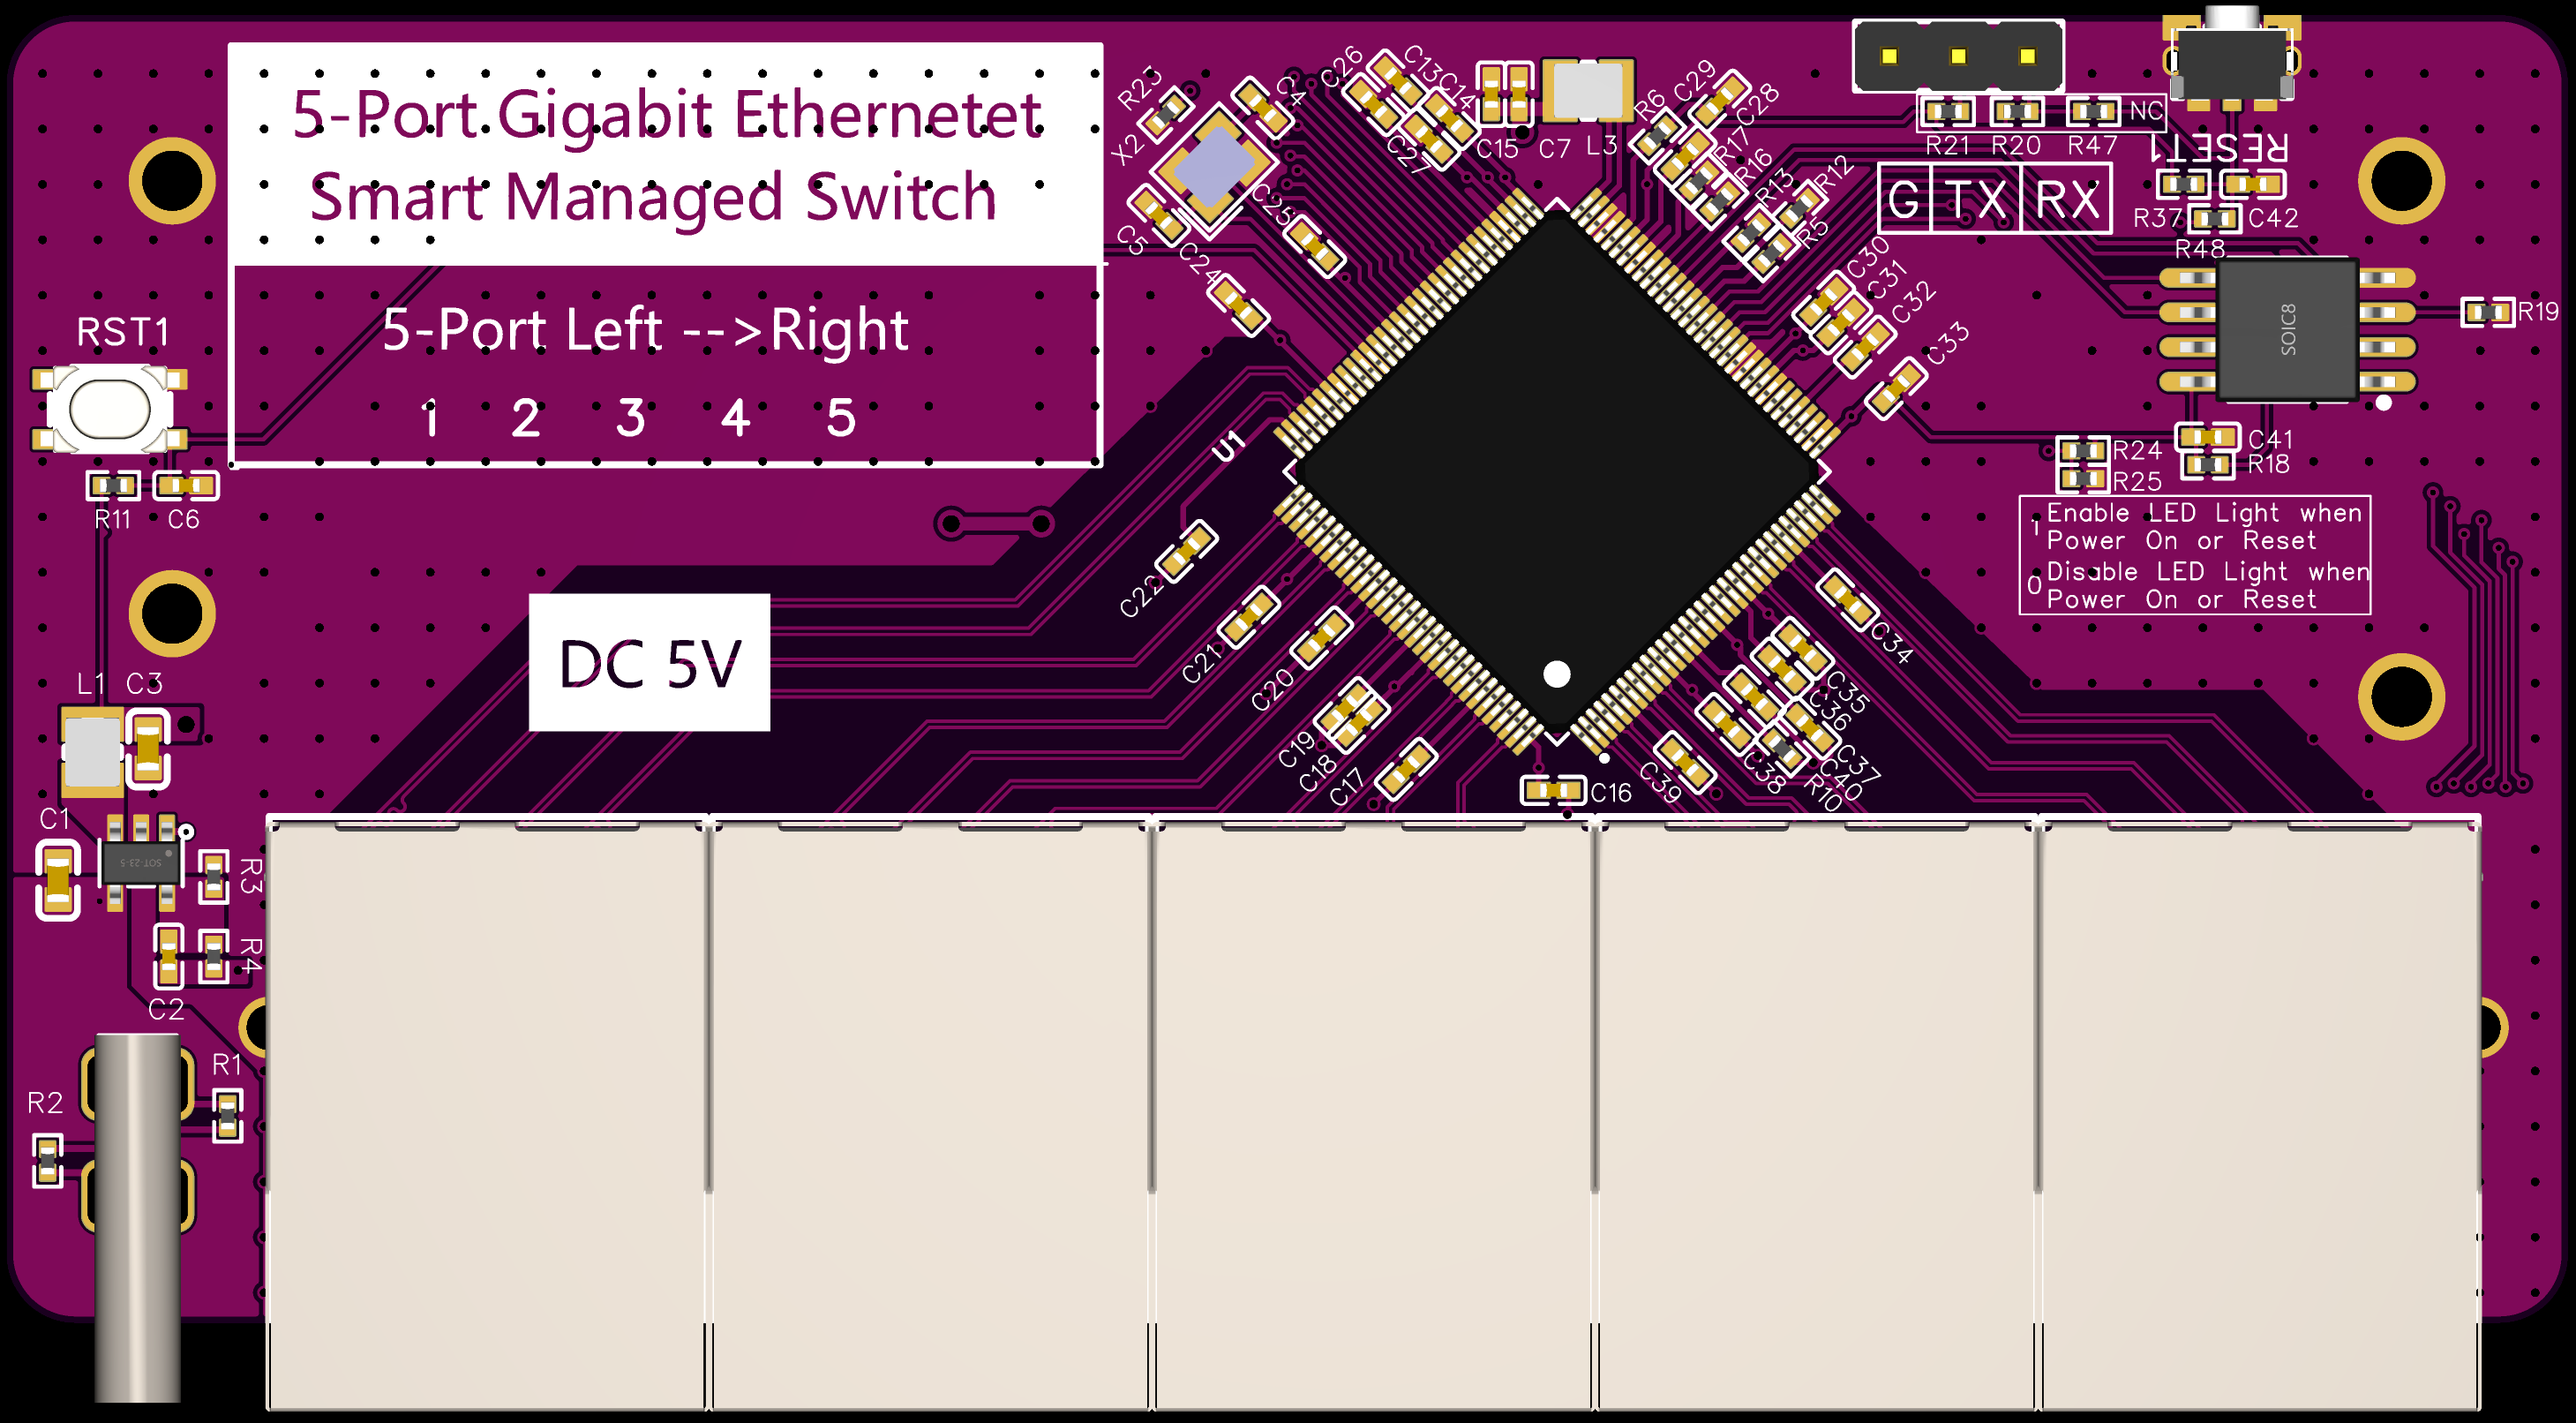
3D效果图

固件

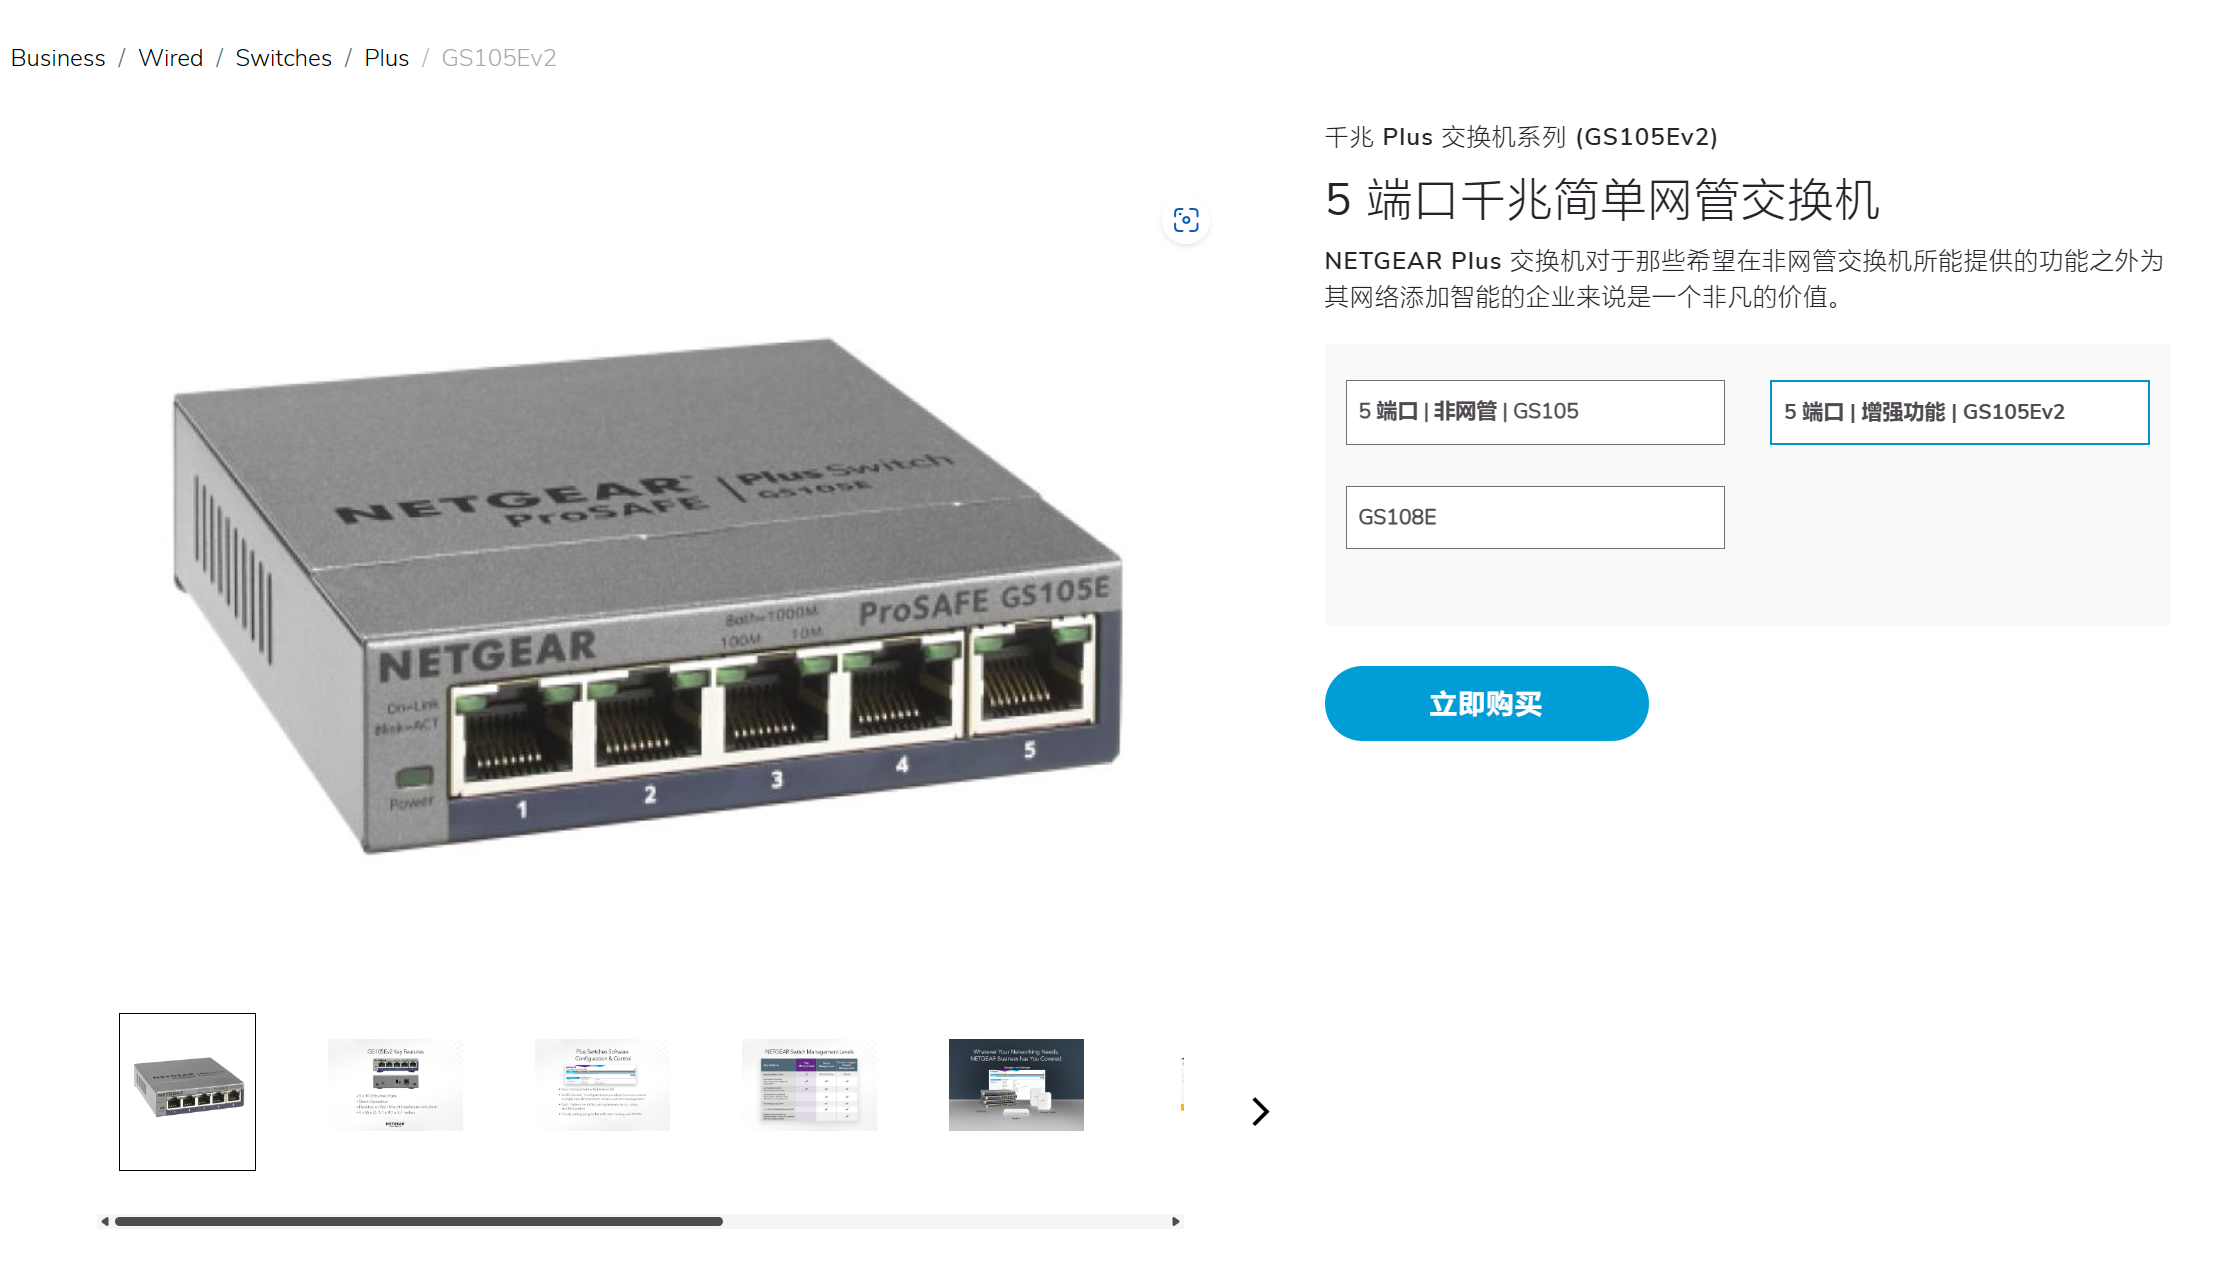
借用网件GE105Ev2的固件

https://www.netgear.com/cn/business/wired/switches/plus/gs105ev2/

网件固件.bin,大小2M。

使用烧录器(例如CH341)烧写到 spi norflash中。

修改mac地址

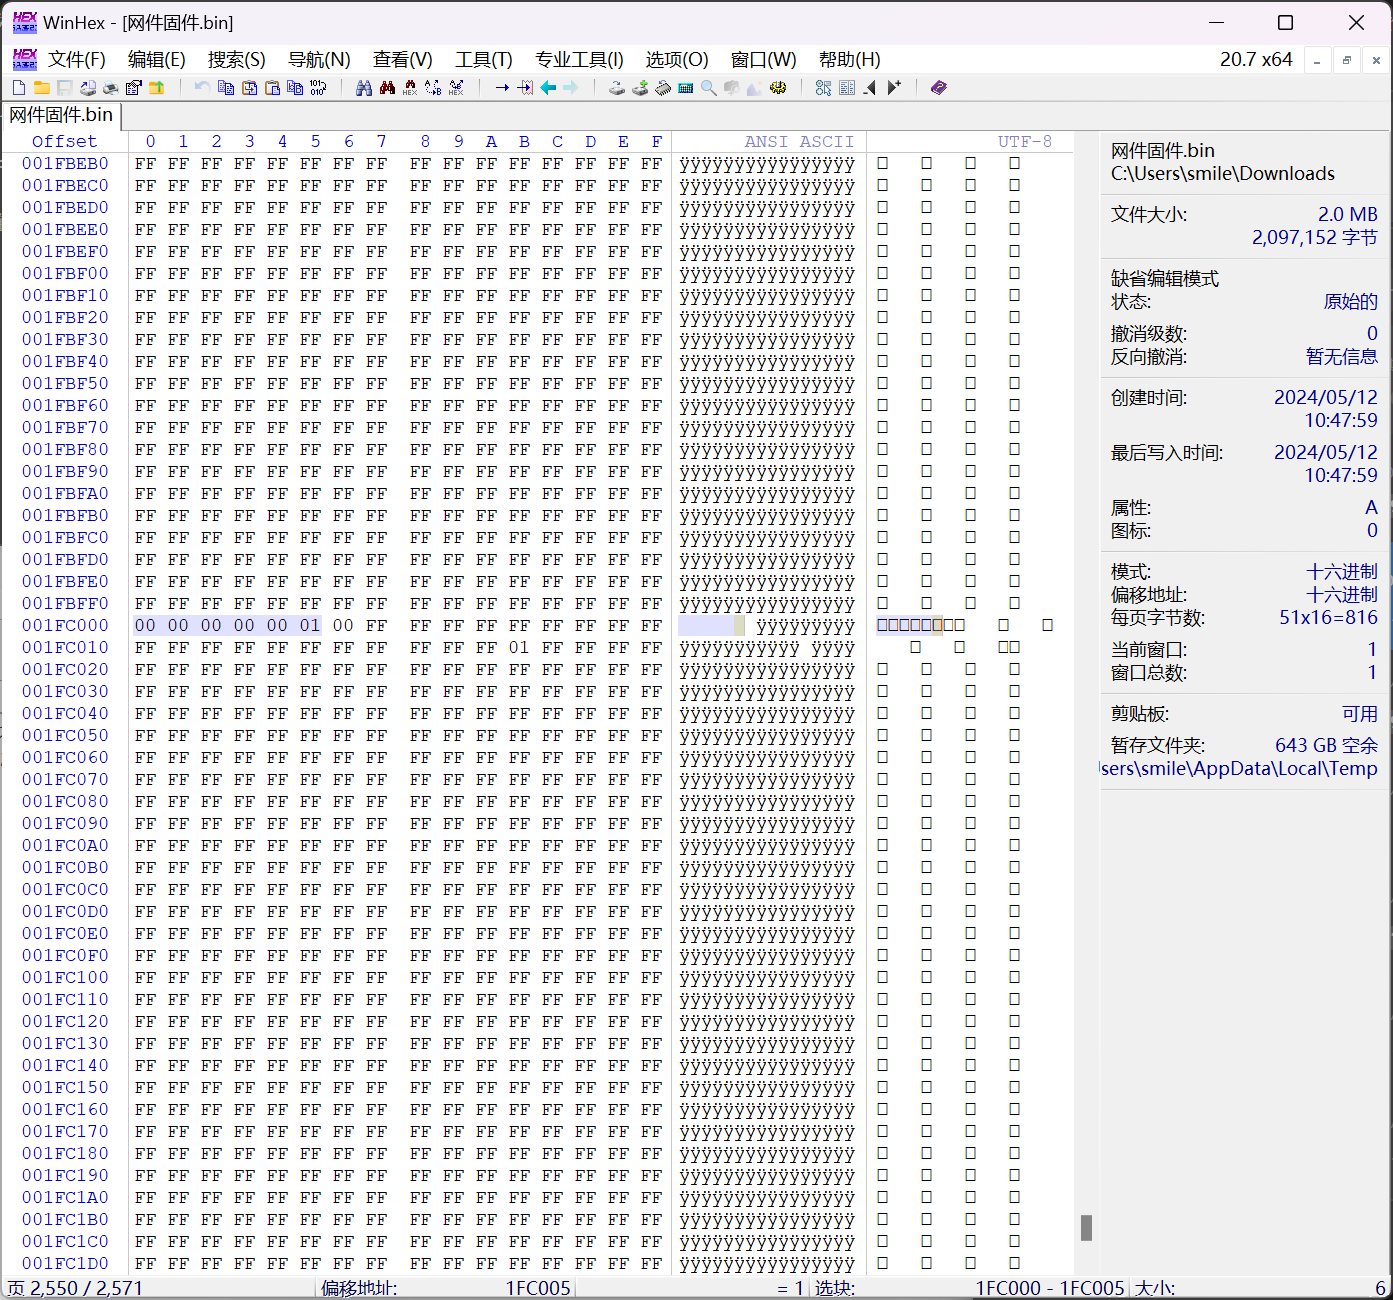
固件MAC地址固定为00:00:00:00:00:01,编辑固件中偏移地址 0x1FC000指定MAC地址,可以随机生成MAC

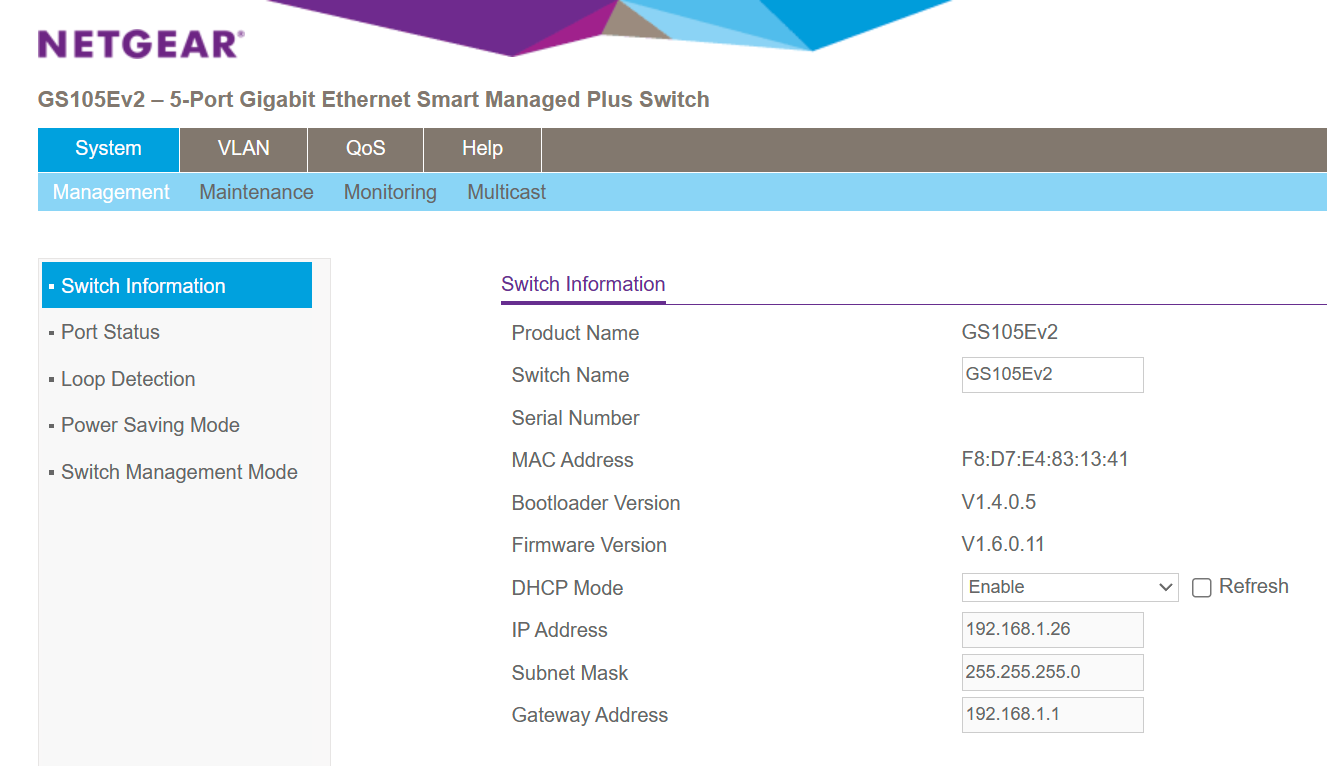
web管理截图


  1. RTL8367S-CG_Datasheet.pdf ↩︎

C语言零长数组使用技巧

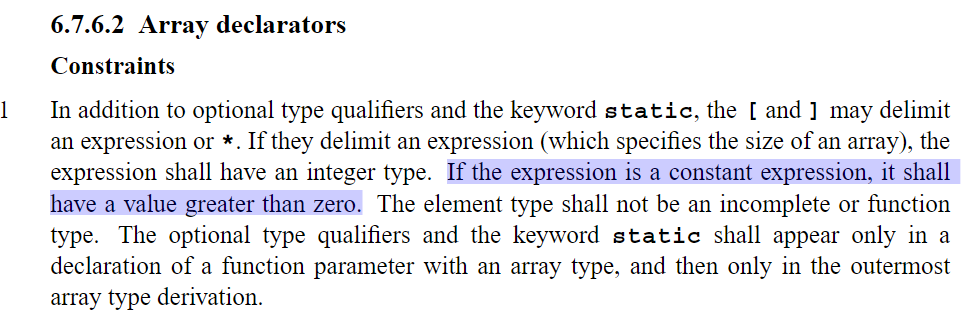
在标准C语言(ANSI C)中规定不能定义长度为0的数组。标准可见 ISO 9899:2011 章节 6.7.6.2


数组长度的声明表达式中,如果表达式是一个常量表达式,它的值应该大于零。

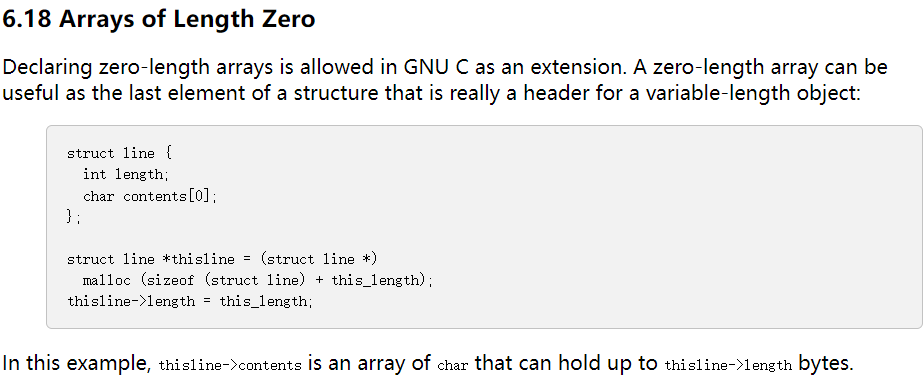
但是,有些编译器就把0长度的数组成员作为自己的非标准扩展,例如GNU C —— Arrays of Length Zero。

什么是零长数组

1
2
3
4
5
6
7
8
#include <stdio.h>

int main() {
int buf[0];
printf("sizeof(int[0]) = %lu", sizeof(buf));
// sizeof(int[0]) = 0
return 0;
}

在程序中定义一个零长度数组,sizeof() 计算出大小为0,也就是说,零长数组是不占用内存空间的。

怎么使用零长数组

零长度数组一般不单独使用,它常常作为结构体的最后一个成员,构成一个变长结构体。

我们定义一个结构体用于接受对端发送的所有传感器数据:

1
2
3
4
5
typedef struct {
uint8_t sensor_num; // 传感器数量
uint8_t single_info_size; // 单个传感器数据size
SENSOR_INFO_S info[0]; // 定义一个零长结构体数组,表示具体数据,数据大小 = sensor_num * sensor_info_size
} SENSOR_RSP_S;

当然我们也可以申请一个指针,指向紧挨SENSOR_RSP_S 结构体的下一个地址,比起指针,用零长数组有这样的优势:

  1. 不需要初始化,数组名直接就是所在的偏移;
  2. 不占任何空间,指针需要占用空间,空数组不占任何空间。意味着无需初始化,数组名就是后面元素的地址,直接就能当指针使用。

使用以上定义的结构体实现以下功能:

1
2
3
4
5
6
7
8
9
10
11
12
13
// 对rsp地址赋值
const SENSOR_RSP_S *rsp = get_sensor_data();
size_t rsp_len = get_sensor_data_length();

// 判断长度合法性,直接使用sizeof(SENSOR_RSP_S)
if (rsp_len != sizeof(SENSOR_RSP_S) + rsp->sensor_num * rsp->single_info_size) {
...
}

// 遍历访问数据,数据描述和数据内容均来自rsp,理解清晰
for (size_t i = 0; i < rsp->sensor_num; i++) {
show_sensor(rsp->info[i]);
}

正则表达式

常用表达式语法

语法 描述 用例
\ 将下一个字符标记为一个特殊字符、或一个原义字符、或一个向后引用、或一个进制转义符。 n匹配字符n。\n匹配一个换行符。连续\\匹配\,而\(匹配(
^ 匹配输入字符串的开始位置
$ 匹配输入字符串的结束位置
* 匹配前面的子表达式零次或多次。*等价于{0,} zo*能匹配z以及zoo
+ 匹配前面的子表达式一次或多次。+等价于{1,} zo+能匹配zo以及zoo,但不能匹配z
? 匹配前面的子表达式零次或一次。?等价于{0,1} password(s)?可以匹配pawwsord或passwords
{n} n是一个非负整数。必须匹配n次 fo{2}d不能匹配fo,但是能匹配foo
{n,} n是一个非负整数。至少匹配n次 go{2,}d不能匹配god,但是能匹配good和gooood
{n,m} m和n均为非负整数,其中n<=m。最少匹配n次且最多匹配m次,请注意在逗号和两个数之间不能有空格。
? 当该字符紧跟在任何一个其他限制符 *,+,?, {n}, {n,}, {n,m} 后面时,匹配模式是非贪婪的。非贪婪模式尽可能少的匹配所搜索的字符串,而默认的贪婪模式则尽可能多的匹配所搜索的字符串 对于字符串oooo,o+?将匹配单个o,而o+将匹配所有o
. 匹配除\n之外的任何单个字符。要匹配包括\n在内的任何字符,请使用像(.|\n)的模式。
(pattern) 匹配pattern并获取这一匹配。所获取的匹配可以从产生的Matches集合得到,要匹配圆括号字符,请使用\( 或 \)
x|y 匹配x或y,也可以多个一起使用x|y|z (b|f)oo能匹配boo或foo。b|foo则匹配b或foo
[xyz] 匹配所包含的任意一个字符 [abc]{2}可以匹配aa或ac或bb等
[^xyz] 匹配未包含的任意一个字符
[a-z] 字符范围。匹配指定范围内的任意字符 [a-z]+可以匹配任意长度的小写字母字符串
\d 匹配一个数字字符。等价于[0-9]
\D 匹配一个非数字字符。等价于[^0-9]
\n 匹配一个换行符。等价于\x0a
\r 匹配一个回车符。等价于\x0d
\s 匹配一个任何空白字符,包括空格、制表符、换页符等等。等价于[\f\n\r\t\v]
\S 匹配一个任何非空白字符,等价于[^\f\n\r\t\v]
\t 匹配一个制表符。等价于\x09
\w 匹配一个包括下划线的任何单词字符。等价于[A-Za-z0-9_]
\W 匹配任何非单词字符。等价于[^A-Za-z0-9_]
\un 匹配Unicode字符,其中n是一个用四个十六进制数字表示的Unicode字符 \u00A9匹配版权符号©,[\u4e00-\u9fa5]匹配中文字符
0%